Executive Summary
이 글은 2026년 10월 20일 중국 허베이성 슝안신구에서 문을 연 회사 하나를 읽는다. 이름은 국가데이터그룹유한공사, 국무원 국자위가 감독하는 신설 중앙기업이다. 모델을 만드는 회사도 아니고 칩을 만드는 회사도 아니다. 이 회사가 파는 것은 데이터다. 부처와 산업별로 갈라져 흐르지 않던 데이터를 모아, 인공지능 산업에 고품질 데이터셋과 말뭉치로 내보내는 일을 공표된 주력 업무로 적었다. 국가가 학습 데이터의 공급자 자리에 직접 앉은 것이다.
이 회사의 성격은 비유로 설명할 필요가 없다. 출자자 명단에 이미 적혀 있다. 국무원과 슝안신구 관리위원회 외에 통신 3사와 전력 2사가 주주로 들어가 있다. 전기와 통신을 대는 회사들 옆에, 데이터를 대는 회사가 같은 줄로 들어선 것이다. 그리고 회사가 밝힌 주력 업무에는 보편적이고 안전한 데이터 서비스와 나란히 산업별 데이터 거버넌스 서비스가 들어 있다. 데이터를 대는 쪽이 그 데이터를 재는 일까지 함께 판다는 뜻이다.
한국은 일주일 앞선 10월 13일, 정부사업에서 나온 인공지능 학습용 데이터를 AI허브에 연계하도록 하는 법 개정안을 국무회의에서 통과시켰다. 2027년 4월 시행 예정이다. 중국은 회사를 만들었고 한국은 의무를 만들었다. 같은 방향에 다른 그릇이다. 그런데 두 설계가 똑같이 비워 둔 칸이 있다. 재는 쪽과 대는 쪽이 갈려 있지 않다. 중국은 공급자에게 거버넌스 서비스를 함께 맡겼고, 한국은 데이터를 받는 주무부처에 품질관리 조치 의무를 얹었다. 여기까지가 두 나라 문서에 적힌 사실이다. 그 빈칸이 무엇을 부를지는 아래에서 해석으로 읽는다.
7곳
국가데이터그룹 출자자
국무원과 슝안신구 관리위원회에 통신 3사와 전력 2사가 더해졌다. 개별 지분율은 공개되지 않았다
187개
이미 있던 지시급 데이터그룹
전국 지급시의 64%. 성급은 29개 이상이다. 국가급은 그 위에 얹혔다(2025년 9월 기준 집계)
691종 → 30종
한국 AI허브 전수 재검토와 선정
2022년까지 쌓인 전수를 다시 보고 생성형 AI용으로 손볼 30종을 골랐다. 예산 30억 원. 불합격 판정이 아니라 선정이다
102명 중 4명
한국 국가데이터처 데이터 관리 실무
국가데이터관리본부 102명 가운데 데이터 관리 업무를 맡는 과의 실무 인력이 4명이라는 출범 당시 보도
10월 20일, 슝안에서 회사 하나가 문을 열었다
2026년 10월 20일, 허베이성 슝안신구(雄安新区)에서 국가데이터그룹유한공사(国家数据集团有限公司)가 문을 열었다. 국무원 국유자산감독관리위원회, 줄여서 국자위(国资委)가 국가를 대신해 주주 노릇을 하는 중앙기업이다. 중국 매체들은 이 회사가 중앙기업 명부(央企名录) 28위에 올랐고, 이로써 국자위가 감독하는 중앙기업이 다시 100개가 됐다고 전했다. 28과 100은 서로 다른 숫자다. 앞엣것은 명부의 자리이고 뒤엣것은 총수다. 한국어로 옮기는 과정에서 "100번째 중앙기업"이라는 표현이 몇 군데 돌았는데, 그런 순번은 어느 공고에도 없다.
무엇을 하는 회사인지는 관영매체가 비교적 또렷하게 적었다. 신화망 한국어판은 이 회사의 주력 업무를 이렇게 옮겼다.
세 토막 가운데 세 번째가 이 글이 이 회사를 다루는 이유다. 데이터셋과 말뭉치를 인공지능 산업에 공급하는 일을, 지분 전부가 국유 자본인 회사가 사업으로 내걸었다. 그리고 두 번째 토막이 이 글의 질문을 미리 만들어 놓는다. 같은 회사가 산업별 데이터 거버넌스 서비스도 판다. 대는 쪽과 재는 쪽이 한 법인 안에 들어 있다는 뜻인데, 이 이야기는 5절에서 다시 연다.
회사의 성격을 가장 빠르게 보여 주는 것은 업무 설명이 아니라 출자자 명단이다. 돈을 댄 곳이 일곱이고, 그중 다섯이 통신과 전력이다. 중국전신(中国电信)·중국연통(中国联通)·중국이동(中国移动) 세 통신사와 국가전망(国家电网)·중국남방전망(中国南方电网) 두 전력회사가 국무원·슝안신구 관리위원회와 함께 주주로 들어갔다.
페블러스 원본 도식. 출자자 명단은 국자위 공고를 전한 중국 매체 보도를 교차한 것이고, 지분율은 전 매체가 미공개로 적었다.
이 명단이 중요한 이유는 간단하다. "학습 데이터를 전력이나 통신 같은 기간 공급망으로 다루기 시작했다"는 문장은 보통 해석이다. 그런데 이 회사에서는 그 문장이 해석이기 전에 주주 구성 자체다. 전국 단위 망을 깔고 운영하는 회사들, 그러니까 트래픽과 계량과 설비 기록을 손에 쥔 쪽이 데이터 공급 회사의 지분을 나눠 가졌다.
반면 공개되지 않은 것도 분명히 있다. 일곱 출자자의 개별 지분율은 나오지 않았고, 등록자본 역시 공고에 숫자가 없다. 설립을 앞두고 중국 재경 매체에 수백억 위안대라는 추정이 돌았지만 그것은 시장 추산이지 공시가 아니다. 경영진도 마찬가지로 보도 기준이다. 회장 겸 당조서기는 전 중국연통 총경리 젠친(简勤), 총경리는 전 국가데이터국 부국장 천룽후이(陈荣辉)로 전해졌다. 이 글은 공고 원문을 직접 열지 못했고, 그래서 업무 범위를 뺀 나머지는 "보도에 따르면"으로 적는다.
본사를 슝안에 둔 것도 우연이 아니다. 신화망은 슝안이 이 회사의 시험장이자 인큐베이터라고 적었다. 슝안은 베이징의 비수도 기능을 옮겨 받으려고 설계된 신도시이고, 새 제도를 전국에 풀기 전에 먼저 돌려 보는 자리로 쓰여 왔다.
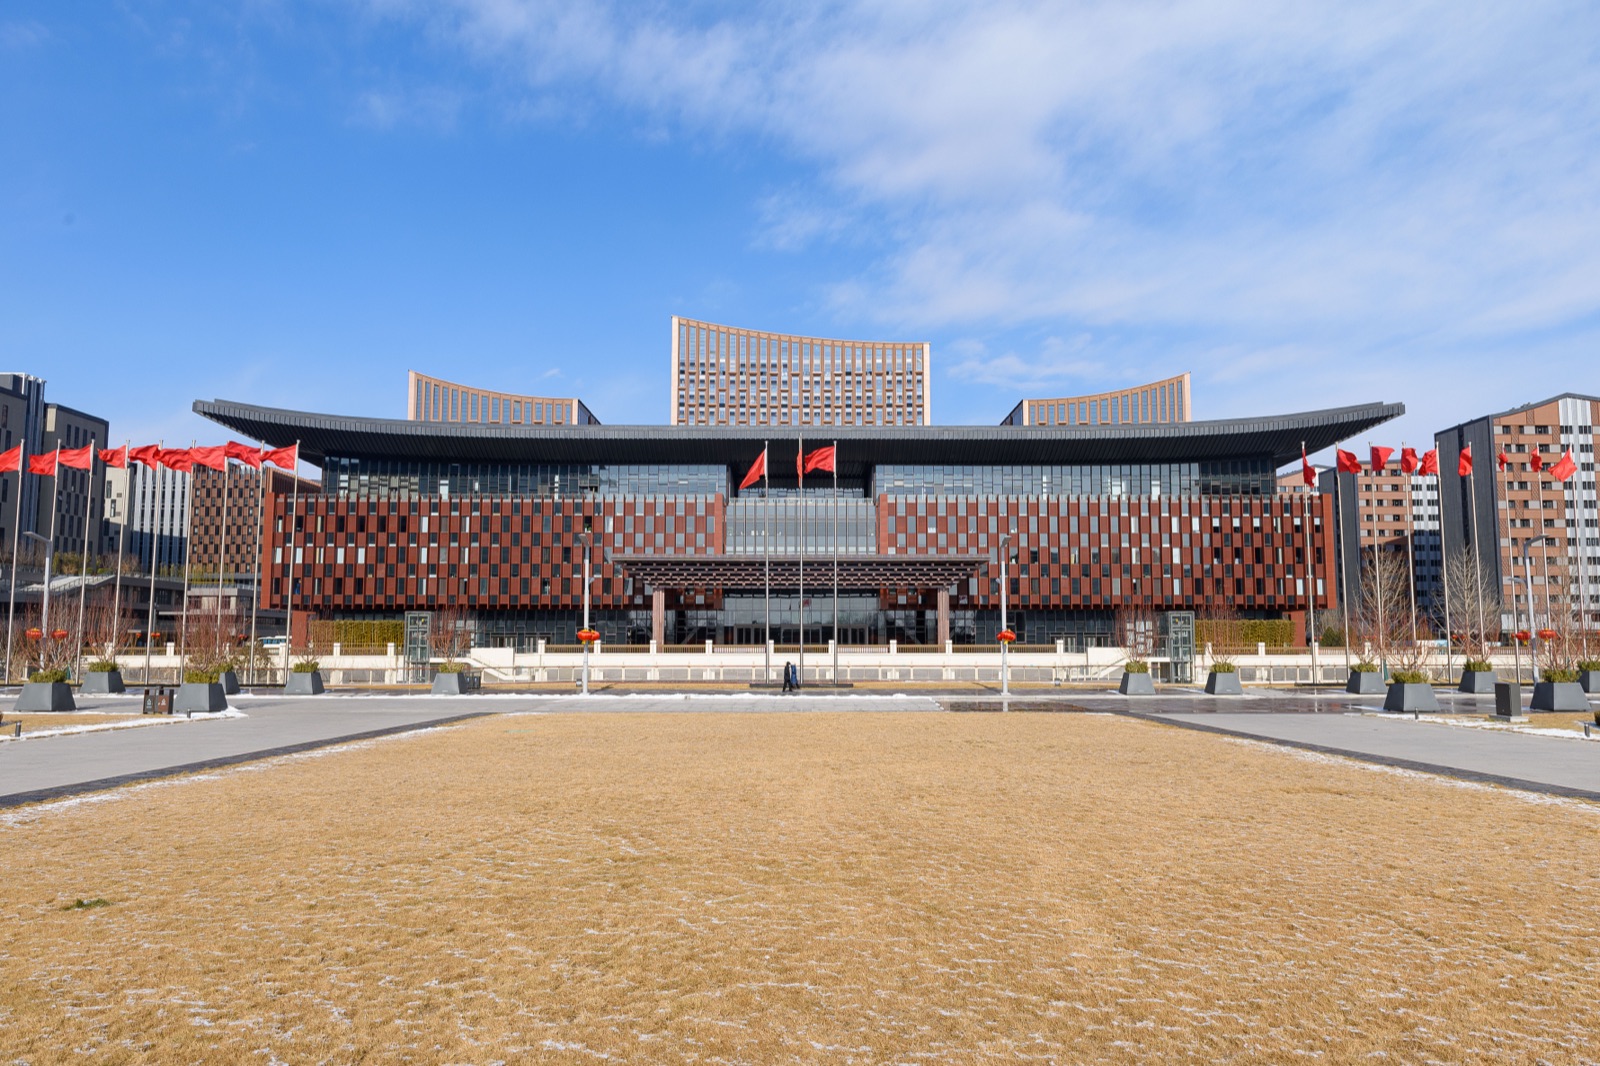
정책을 만든 쪽이 운영할 회사를 세웠다
이름이 비슷해서 자주 섞이는 두 조직이 있다. 국가데이터국(国家数据局)과 국가데이터그룹이다. 앞엣것은 2023년 10월에 생긴 정부 기관이고, 기초 제도와 정책을 설계하는 쪽이다. 뒤엣것은 2026년 10월에 생긴 기업이고, 그 제도 위에서 실제로 데이터를 모아 파는 쪽이다. 한 줄로 줄이면 이렇게 된다. 정책을 만든 쪽이 2년 뒤에 그 정책을 집행할 회사를 세웠다.
두 조직은 사람으로도 이어져 있다. 중국 매체들은 국가데이터그룹 총경리 천룽후이가 국가데이터국 부국장 출신이라고 전했다. 제도를 짠 자리에 있던 사람이 그 제도의 운영 회사를 맡는다. 이것 자체가 잘못됐다고 말할 근거는 없다. 다만 이 글이 5절에서 던질 질문, 그러니까 공급자와 분리된 검증자가 누구냐는 물음이 추상론이 아니게 되는 지점이기는 하다.
또 하나 자주 생기는 오독이 "갑자기 생긴 회사"라는 읽기다. 중국에서 데이터를 모아 파는 국유 회사는 이미 몇 해째 돌아가고 있었다. 상하이데이터연구원이 2025년 9월에 낸 집계로는 성급 데이터그룹이 29개 이상, 지시급(地市级) 데이터그룹이 187개이고, 이는 전국 지급시의 64%에 해당한다. 등록자본도 작지 않다. 상하이 데이터그룹이 50억 위안, 푸젠 빅데이터그룹이 100억 위안이다. 아래 도식은 그 층을 옮긴 것이다.
페블러스 원본 도식. 성급·지시급 수치는 상하이데이터연구원 《전국 데이터그룹 발전 청서 2025》(2025년 9월 기준), 등록자본은 중국 매체 보도.
층이 세 겹이 된 배경에는 공공데이터 수권운영(授权运营)이라는 제도가 있다. 정부가 쥔 공공데이터를 특정 운영 주체에 맡겨 가공하고 유통하게 하는 방식이다. 국가데이터국은 2026년 8월 25일 기준으로 전국 31개 성급 행정구역 가운데 25곳에서 이 제도가 실질적으로 돌아가기 시작했다고 밝혔다. 지방마다 데이터그룹이 먼저 생긴 것은 그 운영 주체가 필요해서였다.
제도 이름만 걸린 것도 아니다. 같은 기관의 조사보고서를 보면 수권운영을 거쳐 흐른 데이터량은 4.93PB에서 7.59PB로 1년 사이 53.96% 늘었다. 지방에 법인을 세우고 그 법인에 공공데이터를 맡기는 방식이 실제로 물량을 움직이고 있었다는 기록이다. 국가급 회사는 그 위에 얹혔다.
시점도 눈여겨볼 만하다. 국가데이터국이 17개 부처와 함께 내놓은 「데이터요소×(数据要素×)」 3년 행동계획은 2024년부터 2026년까지였고, 국가데이터국 스스로 2026년을 마무리의 해로 불렀다. 그 계획이 내건 목표는 두 가지였다. 2026년 말까지 본보기가 될 만한 응용 사례를 300개 이상 만들고, 데이터 산업을 연평균 20% 넘게 키운다는 것이었다. 제도를 까는 3년이 끝나는 자리에서 그 제도를 실어 나를 회사가 국가급으로 생긴 셈이다.
전력과 통신 옆에 데이터를 놓는다
출자자 명단이 보여 준 그림은 더 큰 설계의 한 조각이다. 2026년 6월 9일 블룸버그는 중국이 5년에 걸쳐 약 2조 위안, 달러로 약 2,950억 달러를 전국 데이터센터망에 넣는 계획을 준비하고 있다고 보도했다. 국가발전개혁위원회가 주도하는 초안 단계이고, 2028년까지 전국 단위로 묶인 컴퓨팅망을 가동하는 것이 목표이며, 연산용 칩의 80% 이상을 국내 공급사에서 조달한다는 조건이 붙었다고 전해졌다. 재원으로는 초장기 특별국채와 국가 투자기금이, 운영 주체로는 중국이동과 중국전신 같은 국유 통신사가 거론됐다. 전력망 보강까지 포함하면 총액이 5조 위안을 넘을 수 있다는 소식통 추정도 같은 기사에 실렸다.
여기서 한 가지를 분명히 해야 한다. 이 2조 위안은 국가데이터그룹에 들어가는 돈이 아니다. 보도 시점이 출범보다 넉 달 앞서고, 집행 주체로 거론된 쪽도 다르며, 10월 20일 출범을 다룬 기사 어디에도 이 수치는 등장하지 않는다. 두 사건을 한 흐름으로 읽는 것은 가능하지만, 그것은 해석이지 발표가 아니다. 다만 그 해석을 뒷받침하는 단어 하나가 블룸버그 기사에 있다. 이 데이터센터 계획이 "6대 네트워크(六网)"라 불리는 프로그램의 일부로 소개된 것이다. 컴퓨팅망과 전력망, 통신망, 상수도망, 도시 지하관로, 물류망을 한 묶음으로 깔겠다는 구상이다. 연산과 전기와 물이 같은 목록에 들어가 있다.
규모감을 위해 한 줄만 덧붙인다. 같은 블룸버그 기사는 미국 빅테크들이 2026년 한 해에만 약 7,250억 달러를 인공지능에 쓸 것으로 본다고 적었다. 중국의 5년 계획 총액이 미국 민간의 1년 지출보다 작다. 이 글이 다루는 것은 돈의 크기가 아니라 돈이 흘러가는 칸의 이름이다.
데이터를 기간 공급망으로 다루는 쪽은 그것을 세기 시작한다. 중국은 이미 데이터를 전력 사용량처럼 매년 집계해 발표하고, 하루에 처리한 토큰을 국가 지표처럼 내놓기도 한다. 국가데이터국이 내놓은 최근 수치는 이렇다.
| 무엇을 세는가 | 값 | 기준 |
|---|---|---|
| 연간 데이터 생산총량 | 52.26 ZB | 2025년, 전년보다 27.3% 증가 |
| 데이터 저장총량 | 2.53 ZB | 2025년, 전년보다 21.1% 증가 |
| 인공지능 학습·추론에 쓰인 데이터 | 199.48 EB | 2025년, 전년보다 42.9% 증가. 추론 쪽이 학습 쪽을 처음 넘었다 |
| 공공데이터 개방량 | 37.84 PB | 2025년, 전년 28.73PB에서 증가 |
| 누적 구축된 고품질 데이터셋 | 12.6만 개 | 2026년 8월 기준, 총량 1,815PB 이상 |
| 데이터산업 규모 | 6.78조 위안 | 2025년, 전년보다 15.7% 증가. 데이터 기업 48.2만 개 |
출처: 국가데이터국 《전국 데이터자원 조사보고서(2025년)》(2026년 4월 29일 발표) 및 《중국 데이터산업 발전보고서(2026)》(2026년 8월 28일 발표), 신화망 보도 경유. 생산총량과 저장총량은 서로 다른 지표이니 섞어 읽지 않는 편이 좋다.
표의 맨 윗줄은 한 겹 더 갈린다. 같은 보고서는 52.26ZB 가운데 기업이 만든 몫을 33.54ZB로 집계했다. 비율로 64.18%이고, 전년의 58.30%에서 오른 값이다. 국가가 총량을 세고는 있지만 그 총량의 3분의 2 가까이는 기업에서 나온다. 국가가 데이터를 공급하겠다고 할 때 그 데이터가 어디서 오는지를, 1절의 주주 명단과 이 비율이 같은 쪽으로 가리킨다. 전국 망을 깔고 운영하는 회사들이 출자자로 들어간 이유도 그 자리에 있다.
이 표에 일부러 넣지 않은 칸이 하나 있다. 데이터 요소 시장의 규모다. 국가데이터국은 이 항목을 따로 발표하지 않고, 민간 조사기관 추정치만 돈다. 그런데 그 추정치가 기관마다 1,000억 위안대에서 2,000억 위안대까지 두 배 넘게 벌어진다. 데이터 거래만 세느냐, 가공과 서비스까지 세느냐에 따라 범위가 달라지기 때문이다. 같은 나라의 같은 해를 두고도 잣대가 다르면 숫자가 갈린다는 이야기인데, 이 글이 뒤에서 다룰 질문과 결이 같다. 무엇을 셌는지 적지 않은 수치는 비교가 되지 않는다.
한국은 회사 대신 의무를 만들었다
같은 질문에 한국도 답을 냈다. 중국 출범보다 일주일 앞선 2026년 10월 13일, 국무회의가 인공지능 발전과 신뢰 기반 조성 등에 관한 법률, 줄여서 AI기본법과 데이터산업진흥 및 이용촉진에 관한 기본법의 개정안을 통과시켰다. 두 나라가 일주일 사이에 서로 다른 그릇을 고른 셈이다. 중국은 회사를 만들었고 한국은 의무를 만들었다.
한국 개정안의 핵심은 한 줄로 요약된다. 정부사업을 수행하는 과정에서 구축되거나 산출된 인공지능 학습용 데이터를 AI허브에 연계하고 제공하도록 의무화한 것이다. 예외는 대통령령에 맡겼다. 영업비밀 보호, 개인정보나 저작권 침해, 국가 안전보장 같은 사유가 거론됐고 구체적인 범위는 시행령에서 정해진다. 그 네 가지에 해당하는지를 사업 수행자가 판단한다는 점은 따로 읽은 적이 있다. 데이터산업법 쪽은 공공과 민간 데이터의 소재 정보를 한 창구에서 찾게 하는 이른바 원-윈도우 체계를 보강했다. 과기정통부장관이 공공기관과 민간 법인에 소재 정보 연계를 요청할 수 있고, 공공기관은 특별한 사유가 없으면 응해야 한다.
시점은 아직 앞에 있다. 공포 후 6개월, 그러니까 2027년 4월 시행 예정이다. "이미 의무화됐다"는 서술은 지금 시점에서 정확하지 않다. 그리고 이 개정안에서 품질을 다루는 조항의 주어가 누구인지가 이 글에는 특히 중요하다. 연계되고 제공된 학습용 데이터의 안정적 품질관리를 위해 필요한 조치를 하도록 한 대상은 과기정통부장관과 관계 중앙행정기관의 장이다. 데이터를 내는 쪽도, 받아서 쓰는 쪽도 아닌, 데이터를 받아 모으는 쪽이 품질도 맡는다.
한국에는 조직 쪽 움직임도 있었다. 2025년 10월 1일 통계청이 국가데이터처로 승격했다. 1990년 개청 이후 35년 만이다. 다만 인력은 689명에서 699명으로 10명 늘었고, 새로 생긴 국가데이터관리본부는 102명 규모다. 출범 당시 보도는 그중 데이터 관리 업무를 맡는 과의 실무 인력이 4명에 그친다는 내부 지적을 전했다. 아래 표는 두 나라 설계를 같은 칸에 놓고 본 것이다.
| 칸 | 중국 | 한국 |
|---|---|---|
| 만든 것 | 지분 회사 | 연계 의무 |
| 시점 | 2026년 10월 20일 출범 | 2026년 10월 13일 국무회의 통과, 2027년 4월 시행 예정 |
| 데이터를 모으는 주체 | 국가데이터그룹(국유 중앙기업) | AI허브(과기정통부·한국지능정보사회진흥원) |
| 데이터를 내는 쪽 | 출자 통신·전력사 및 공공데이터 수권운영 체계 | 정부사업 수행 기관 |
| 품질을 맡는 쪽 | 공급자 자신(산업별 데이터 거버넌스 서비스를 함께 제공) | 과기정통부장관과 관계 중앙행정기관의 장 |
| 공개된 돈 | 등록자본 미공개 | 쌓인 데이터를 다시 고르는 재가공 사업 30억 원(2026년) |
| 아래층 | 성급 29개 이상, 지시급 187개 데이터그룹 | 국가데이터처(2025년 10월 승격), 국가데이터관리본부 102명 |
출처: 중국 쪽은 신화망과 국자위 공고를 전한 중국 매체, 국가데이터국 발표. 한국 쪽은 과학기술정보통신부 2026년 10월 13일 보도자료를 전한 보도와 국가데이터처 출범 보도. 두 나라의 수치는 측정 대상이 달라 크기 비교용이 아니다.
표를 세로로 읽으면 차이가 보이고, 가로로 읽으면 닮은 자리가 보인다. 차이는 그릇이다. 한쪽은 주주가 있는 법인을 세웠고, 다른 쪽은 기존 플랫폼에 법으로 의무를 얹었다. 닮은 자리는 아래에서 두 번째 줄이다. 품질을 맡는 쪽이 둘 다 데이터를 모으는 쪽과 같다.
품질은 누가 재는가, 못 쓰게 된 데이터는 누가 책임지나
앞의 네 절은 확인한 것이고, 이 절부터가 이 글이 묻고 싶었던 자리다. 국가가 학습 데이터를 모아 대 주면 질문 둘이 바로 따라붙는다. 하나는 품질을 판정하는 일이고, 다른 하나는 하자가 드러난 뒤에 책임지는 일이다.
5.1대는 쪽이 재는 쪽을 겸하고 있다
중국 쪽 답은 설립 문서에 이미 적혀 있다. 1절에서 옮긴 업무 범위 세 토막 가운데 둘째 토막이 산업별 데이터 거버넌스 서비스였다. 데이터를 공급하는 회사가 그 산업의 데이터를 정돈하고 관리하는 일도 상품으로 판다는 뜻이다. 자기가 댄 데이터를 자기가 돌아보는 구조가 회사의 사업 목록 단계에서 이미 들어가 있다.
한국 쪽 답은 조문에 있다. 연계되고 제공된 학습용 데이터의 품질관리에 필요한 조치를 할 주체가 과기정통부장관과 관계 중앙행정기관의 장이다. 즉 데이터를 받아 모으는 쪽이 그 품질도 맡는다. 두 설계는 그릇이 다른데 비워 둔 칸이 같다. 공급과 분리된 검증 주체가 어느 쪽에도 없다.
한국에 품질을 재는 틀 자체가 없다는 말은 아니다. 행정안전부는 공공데이터 품질관리 수준진단과 평가를 운영한다. 지표 체계는 3개 영역 8개 지표이고, 2025년에는 684개 기관의 7,416개 데이터베이스가 대상이었다.
여덟 지표가 각각 무엇을 보는지로 갈라 놓으면 무게가 한쪽에 쏠린다. 다섯은 품질관리 체계를 본다. 평가 대상 데이터베이스를 어떻게 관리하는지, 표준과 구조와 연계를 어떻게 잡아 두었는지, 오류를 미리 막는 절차가 있는지 같은 것들이다. 데이터 값 자체를 보는 지표는 품질진단과 오류율 둘이고, 나머지 하나는 진단 결과에 조치를 했는지를 본다. 여덟 칸 가운데 다섯 칸이 관리를 어떻게 하고 있는지에 돌아가 있다.
이것과 별개로 운영되는 공공데이터 운영실태 평가에서는 같은 해에 관리체계 점수가 높게 나온 기관들이 AI가 쓸 수 있는 데이터 항목에서는 낮은 점수를 받았다. 다만 이 제도는 소관도 대상도 다르다. 행정안전부가 공공데이터를 보는 틀이고, AI 학습용 데이터를 쌓는 AI허브는 과기정통부와 한국지능정보사회진흥원 쪽 사업이다. 행정안전부가 관리하는 공공데이터 제공 표준 데이터셋이 300종이라는 수치가 AI허브 이야기와 같은 문장에 섞여 돌기도 하는데, 서로 다른 제도의 숫자다.
5.2쌓는 일과 고르는 일은 다른 공정이다
이 질문에 가장 또렷하게 답한 자료는 중국 것이 아니라 한국 것이다. 과기정통부가 10월 13일에 밝힌 바로는, 정부사업으로 구축된 인공지능 학습용 데이터는 2025년 말 기준 945종이고 올해 구축 중인 10종을 더하면 955종이다. 공급 쪽 숫자는 해마다 늘어 왔다. 다만 이 종수라는 단위 자체가 기록마다 흔들린다는 것도 알아 둘 만하다. 같은 데이터를 두고 보도자료와 개방 창구가 서로 다른 수를 적은 사례를 앞서 확인한 적이 있다.
그런데 2026년 5월, 정부는 따로 사업을 하나 벌였다. 2022년까지 AI허브에 쌓인 691종을 전수로 다시 보고, 생성형 인공지능에 쓸 수 있게 확장할 여지와 활용도를 기준으로 외부 전문가 검토를 거쳐 재가공 대상 30종을 골랐다. 예산은 30억 원이었다. 여기서 한 가지를 분명히 해 두는 편이 좋다. 30종은 고른 수이지 나머지 661종을 못 쓴다고 판정한 수가 아니다. 그런 판정을 담은 문서는 없고, 30억 원이라는 예산이 고를 수 있는 폭을 제약했을 가능성도 함께 봐야 한다.
페블러스 원본 도식. 955종은 2025년 말 기준 누적 구축분에 올해 구축 중인 10종을 더한 수이고, 691종은 2022년까지의 구축분이다. 기준 시점이 다른 두 수이므로 "955종 중 30종"으로 읽으면 틀린다. 30종은 재가공 대상으로 고른 수이지 나머지에 대한 불합격 판정이 아니다.
이 사업이 말해 주는 것은 단순하다. 쌓는 일과 고르는 일은 다른 공정이고, 다른 예산과 다른 절차와 다른 사람의 검토를 쓴다. 이미 쌓아 둔 데이터를 새 용도에 맞춰 쓰려면 전수로 다시 열어 봐야 했고, 그 일에 따로 돈이 붙었다. 공급 종수가 늘었다고 품질이 따라 오르지 않는다는 사실을, 한국은 자기 자료로 한 번 보여 준 셈이다. 이것은 한국의 실패담이 아니라 두 나라가 같이 안고 있는 숙제의 실물이다. 중국의 공급 규모는 훨씬 크고, 그 규모를 다시 열어 보는 일은 더 비싸다.
책임 쪽 칸은 더 비어 있다. 국가가 공급한 데이터에 출처가 불분명한 자료나 이용 조건이 맞지 않는 자료가 섞여 있었다면, 그걸로 학습한 모델을 만든 기업은 누구에게 무엇을 물을 수 있는가. 두 나라 문서 어디에도 그 답이 없다. 중국 쪽은 공급자가 거버넌스까지 맡는 구조여서 묻는 상대와 답하는 상대가 같고, 한국 쪽은 품질관리 조치 의무가 행정기관에 있을 뿐 제공받은 데이터의 하자에 대한 책임 배분 규정이 아니다.
한 창구에서 받아 쓰면 실패도 같이 온다
공급 창구가 하나로 모이면 무엇이 달라지는가. 이 물음에는 정책 문서가 아니라 학술 쪽에 축적된 답이 있다. 핵심은 공급망이 좁아질 때 위험이 사라지는 게 아니라 서로 상관을 갖게 된다는 것이다. 각자 긁어 쓰던 시절에는 흩어져 있던 결손과 편향이, 같은 자료를 받아 쓰는 순간 모델들의 공통 실패가 된다.
그 축적을 여섯 줄로 묶으면 세 갈래가 섞여 있다. 같은 구성요소를 공유한 쪽들의 결과가 서로 닮아 가는지를 직접 잰 연구가 둘, 지금 쓰이는 데이터의 출처가 얼마나 추적되고 얼마나 남아 있는지를 센 감사가 둘, 그리고 쌓인 자료를 되먹이거나 걸러 낼 때 무엇이 달라지는지를 잰 실험이 둘이다. 칸은 두 개로 나눴다. 각 연구가 실제로 잰 것, 그리고 그 연구가 닿지 않는 범위다.
| 무엇을 본 연구인가 | 잰 것 | 한계 |
|---|---|---|
| 알고리즘 단일재배(Bommasani 외, NeurIPS 2022) | 구성요소를 공유한 의사결정자들의 결과가 얼마나 닮는가. 특히 학습 데이터를 공유할 때 결과 동질화가 분명히 심해졌다 | 모델 공유만으로는 효과가 섞여 나왔다 |
| 채용 알고리즘 실증(2026) | 지원자 300만 명, 지원 400만 건 규모의 채용 자료에서 같은 벤더 알고리즘을 거친 지원자가 체계적으로 탈락하는 양상 | 채용과 배분 맥락이다. 사전학습 말뭉치에서 같은 일이 일어난다는 직접 실증이 아니다 |
| 데이터 출처 감사(Data Provenance Initiative, 2023) | 널리 쓰이는 데이터셋 1,800여 개를 감사한 결과 라이선스 정보 누락이 72% 이상, 오류율이 50% 이상 | 공개 데이터셋 모음이 대상이라 비공개 사내 자료는 빠져 있다 |
| 데이터 공유지의 폐쇄(NeurIPS 2024) | 1년 사이에 C4의 핵심 출처 가운데 28% 이상이 로봇 배제 규약으로 완전히 막혔고, 뉴스 도메인은 거의 45% | 웹 공개 자료에 한정된 관측이다 |
| 모델 붕괴(Shumailov 외, Nature 2024) | 생성물을 되먹여 학습하면 분포의 꼬리가 사라지고 그 결함이 되돌아오지 않는다 | 합성 데이터를 섞는 비율과 방식에 따라 양상이 달라진다 |
| 중복 제거와 선별(D4, NeurIPS 2023) | 중복을 걷어낸 위에 선별을 더하면 학습 효율이 20% 오르고 16개 과제 평균 정확도가 최대 2% 개선 | 특정 모델 규모와 말뭉치에서 잰 값이다 |
출처: 각 논문 원문. 잰 것 칸은 논문이 보고한 수치를 옮겼고, 한계 칸은 저자들이 스스로 적은 범위와 이 글의 주제에 비춘 적용 범위를 함께 적었다.
표의 둘째 줄 한계 칸을 그냥 지나치면 안 된다. 단일재배 실증은 채용과 배분 맥락에서 나왔고, 대규모 언어모델의 사전학습 말뭉치에서 같은 일이 벌어진다고 증명한 연구는 아직 없다. 국가 창구 이야기를 하면서 이 연구들을 끌어다 쓸 때, "같은 데이터를 받아 쓰면 모델도 똑같이 망가진다"로 넘기면 과장이 된다. 지금까지 말할 수 있는 것은 이쪽이다. 구성요소를 공유할수록 결과가 닮는 경향이 관측됐고, 그중 학습 데이터 공유가 가장 분명한 축이었다.
그리고 반대 방향의 사실도 같이 놓아야 공정하다. "국가 창구는 집중이고 민간은 분산"이라는 대비는 틀렸다. 2019년부터 2023년 사이에 공개된 언어모델 47개 가운데 64% 이상이 걸러 낸 Common Crawl을 바탕으로 학습했고, GPT-3는 학습 토큰의 80% 이상을 거기서 가져왔다. 비영리 단체 한 곳이 긁어 모은 웹 사본에 산업 전체가 기대 온 것이다. 집중은 국가가 창구를 만들어서 생긴 현상이 아니라 이미 있던 조건이고, 국가 창구는 그 집중의 주인이 누구인지를 바꾼다.
스펙트럼의 또 다른 끝에는 유럽이 있다. 유럽연합 데이터법은 2023년 12월 관보에 실렸고 대다수 조항이 2025년 9월 12일부터 적용되기 시작했으며, 2026년 9월 12일부터는 설계 단계에서 접근성을 보장하라는 요구가 더해졌다. 다만 2026년 9월 기준으로 27개 회원국 가운데 소관 당국 지정을 마친 곳은 6개국뿐이다. 유럽은 공급자를 세우는 대신 접근 규칙을 세웠는데, 그 규칙을 집행할 사람을 아직 다 앉히지 못했다. 회사를 세우든, 의무를 얹든, 규칙을 쓰든, 세 방식 모두 같은 자리에서 멈춰 있다. 데이터가 쓸 만한지 재는 일을 누가 맡는지가 비어 있다.
페블러스 관심의 이유
1절부터 6절까지는 두 나라의 공식 문서와 발표, 그리고 학술 문헌에서 확인한 것이다. 이 절은 그 문서들이 하지 않은 이야기이고, 페블러스가 왜 이 사건을 오래 들여다봤는지에 관한 것이다.
7.1페블러스는 데이터를 만들지 않는다
두 설계를 나란히 놓고 보면 공통점이 하나 남는다. 데이터를 모아 대 주는 쪽은 꼼꼼하게 설계했는데, 모인 데이터가 쓸 만한지 보는 일은 같은 손에 맡겼다. 중국은 공급자에게 산업별 데이터 거버넌스 서비스를 함께 맡겼고, 한국은 데이터를 받아 모으는 부처에 품질관리 조치 의무를 얹었다. 페블러스가 AI-Ready Data와 데이터클리닉으로 하는 일이 정확히 그 갈라지지 않은 자리에 있다. 데이터를 만들지 않고, 만든 데이터가 쓸 만한지만 본다.
7.2공급망이 좁아지면 결손도 공유된다
데이터 품질을 기업 단위에서 보던 이야기가 국가 단위로 올라간 사례라는 점에서 이 사건은 특별하다. 한 창구에서 받은 말뭉치로 여러 모델이 학습하면, 그 말뭉치의 결손과 편향과 중복이 모델들의 공통 실패가 된다. 6절에서 봤듯 학습 데이터를 공유할 때 결과가 가장 분명하게 닮는다는 관측이 이미 있다. 다만 그 관측의 맥락은 채용과 배분이었고, 사전학습 말뭉치에서 같은 일이 일어난다는 증명은 아직 없다. 그래서 우리는 이 자리에서 단정하지 않고, 대신 측정 가능한 질문으로 바꿔 둔다. 국가 창구가 내보내는 데이터셋마다 출처와 이용 조건과 결손율이 함께 나오는가.
7.32027년 4월, 숙제가 실무로 내려온다
한국 개정안은 2027년 4월 시행 예정이다. 그때부터 정부사업을 수행하는 기관은 산출 데이터를 AI허브에 내야 하고, 그 데이터가 어떤 상태인지 설명할 수 있어야 한다. 내기 전에 데이터 상태를 진단해 두는 일이 실무 과제로 새로 생긴다는 뜻이다. 한국은 그 일의 비용을 이미 한 번 치러 봤다. 2022년까지 쌓인 691종을 전수로 다시 열어 재가공할 30종을 고르는 데 30억 원이 들었다. 쌓을 때 함께 적어 두지 않으면, 나중에 전수로 다시 여는 쪽이 비용을 치른다.
중국 쪽 데이터를 들여다 쓰려는 기업에는 다른 숙제가 붙는다. 국가데이터그룹이 내보낼 데이터셋의 출처와 이용 조건이 어디까지 추적되는지가 선결 조건이 된다. 6절에서 본 감사 결과를 떠올리면 이 걱정은 막연한 게 아니다. 널리 쓰이는 공개 데이터셋에서도 라이선스 정보 누락이 72%를 넘었다.
7.4검증자 자리는 아직 비어 있다
국가가 데이터를 모아 주면 품질은 누가 보는가. 이 질문에 답을 적어 둔 설계가 아직 없다. 회사를 세운 쪽도, 의무를 얹은 쪽도, 규칙을 쓴 쪽도 마찬가지다. 비어 있다는 것은 곧 그 자리가 제도 차원에서 열린다는 뜻이기도 하다. 페블러스는 공급자의 경쟁자가 아니라 공급과 분리된 검증자로 선다. 데이터를 더 많이 모으는 경쟁에는 끼지 않고, 모인 데이터가 쓸 만한지 밖에서 보는 쪽에 선다.
본문에서 국가데이터그룹의 업무 범위는 신화망 한국어판이 축자로 실은 문장을 옮겼고, 그 밖의 사실은 국자위 공고를 전한 중국 매체 보도를 교차해 "보도에 따르면"으로 적었다. 공고 원문과 회사 공식 사이트는 이번 작업에서 직접 열지 못했으며, 등록자본과 개별 지분율은 공개되지 않아 미공개로 남겨 뒀다. 한국 쪽 조문 내용과 시행 시점은 과학기술정보통신부 2026년 10월 13일 보도자료를 전한 복수 매체에서 확인했다. 2조 위안 투자 계획은 2026년 6월 9일 블룸버그 보도이고 국가데이터그룹과는 별개 사안이어서, 본문에서 시차와 주체를 문장마다 밝혔다. AI허브 30종은 재가공 대상으로 고른 수이지 나머지에 대한 불합격 판정이 아니며, 이 구분도 본문에 적었다. 1절부터 6절까지는 확인한 것이고 7절은 그 문서들이 하지 않은 이야기이니 나눠서 읽어 주시기 바란다. 긴 글 읽어 주셔서 감사하다.
참고문헌
출처의 등급이 갈리므로 묶어서 적는다. 첫 묶음은 정책 문서와 통계 보고서이고, 본문의 중국 쪽 수치와 한국 쪽 조문이 여기서 나왔다. 둘째 묶음은 보도인데, 이 글에서 국가데이터그룹의 출자자와 경영진은 공고 원문이 아니라 이 묶음을 교차해 얻은 것이라 본문에서도 그렇게 적었다. 셋째 묶음은 학술 문헌으로, 6절의 한계 칸은 저자들이 스스로 밝힌 범위를 옮긴 것이다.
정책·통계 (1차)
- 1.国务院国资委. 2026년 제1호 공고 — 국가데이터그룹유한공사 설립 비준. ⚠️ 원문을 직접 열지 못해 매체 경유로 인용했고, 본문에서도 그렇게 적었다.
- 2.国家数据局. 《全国数据资源调查报告(2025年)》(2026-04-29) — 3절 표의 생산총량 52.26ZB, 저장총량 2.53ZB, 학습·추론용 데이터 199.48EB, 공공데이터 개방량 37.84PB가 여기서 나왔다. 표 뒤에 적은 기업 생산분 33.54ZB(64.18%, 전년 58.30%)와 2절의 수권운영 데이터량 4.93PB에서 7.59PB로의 증가도 같은 보고서다. nda.gov.cn
- 3.国家数据局. 《中国数据产业发展报告(2026)》(2026-08-28) — 데이터산업 규모 6.78조 위안, 데이터 기업 48.2만 개, 누적 고품질 데이터셋 12.6만 개·1,815PB. nda.gov.cn
- 4.国家数据局. 「数据要素×」 3년 행동계획(2024–2026) 성과 발표(2026-06-25) — 2절의 계획 기간과 마무리 해 서술, 그리고 그 계획이 내건 두 목표(2026년 말까지 응용 사례 300개 이상, 데이터 산업 연평균 20% 초과 성장). news.cn
- 5.国家数据局 발표(2026-08-25) — 공공데이터 수권운영(授权运营)이 31개 성급 행정구역 중 25곳에서 실질 개시됐다는 2절 서술.
- 6.上海数据研究院. 《全国数据集团发展蓝皮书2025》(2025-09 기준) — 2절 도식의 성급 29개 이상, 지시급 187개, 전국 지급시의 64%.
- 7.과학기술정보통신부 보도자료(2026-10-13) — AI기본법·데이터산업법 개정안 국무회의 통과. 4절의 의무 대상, 예외 사유, 품질관리 조치 주체, 2027년 4월 시행, 그리고 5절의 누적 945종과 구축 중 10종이 여기서 나왔다.
- 8.행정안전부. 공공데이터 품질관리 수준진단·평가 — 5절의 3개 영역 8개 지표, 2025년 684개 기관 7,416개 데이터베이스, 그리고 공공데이터 제공 표준 데이터셋 300종. 8개 지표의 내역(품질관리 체계 5 · 데이터 값 관리 2 · 진단결과 조치 1)도 같은 공고 기준이다. mois.go.kr
- 9.Regulation (EU) 2023/2854(EU 데이터법) 및 Bird & Bird, "The EU Data Act: Where Things Stand Now"(2026-09) — 6절의 적용 시점과 27개국 중 6개국만 소관 당국을 지정했다는 서술. twobirds.com
보도 (귀속 명시해 사용)
- 10.신화망 한국어판. 국가데이터그룹 출범(2026-10-22) — 1절 인용 상자의 업무 범위 축자와 슝안이 시험장이자 인큐베이터라는 서술. 이 글에서 관영매체 축자로 확정한 유일한 핵심 문장이다. 이 기사에는 중앙기업 총수 100개라는 수가 없다. kr.xinhuanet.com
- 11.澎湃新闻. "国家数据集团有限公司组建成立,位列央企名录第28位" — 1절의 명부 28위, 총수 100개, 출자자 일곱 곳, 경영진 이력. 腾讯·新浪财经·虎嗅·凤凰网·搜狐 보도와 교차했다. thepaper.cn
- 12.머니투데이(2026-10-21) · 한국일보(2026-10-21) — 국내 출범 보도. 두 기사 모두 2조 위안 수치를 담고 있지 않다는 점을 3절 서술의 근거로 썼다. mt.co.kr
- 13.Bloomberg. "China Prepares $295 Billion Plan to Fund Nationwide AI Buildout"(2026-06-09) — 3절의 2조 위안, 2028년 통합 컴퓨팅망, 국산 칩 80%, 전력 포함 5조 위안, 6대 네트워크, 미국 빅테크 2026년 약 7,250억 달러. 초안 단계 보도임을 본문에 밝혔다. Tom's Hardware 후속 분석으로 교차했다. bloomberg.com
- 14.新华网. "2025年我国年度数据生产量达52.26ZB"(2026-08-07) — 3절 표의 증가율 표기를 이 기사 축자(同比增长27.3%)에 맞췄다. news.cn
- 15.한국데이터경제신문 · ZDNet Korea(2026-05) — 5절의 691종 전수 분석, 재가공 대상 30종 선정, 예산 30억 원. ⚠️ 기사 제목이 쓴 "쓸 만한 건 30종뿐"이라는 틀은 본문 서술에서 채택하지 않았다. 기사 본문의 축자는 전수 분석 뒤 외부 전문가 검토로 30종을 최종 선정했다는 것이고, 나머지를 못 쓴다고 판정한 문서는 없다. dataeconomy.co.kr
- 16.뉴스핌(2026-10-13) · 부산일보(2025-09-30) — 4절의 개정안 해설과 국가데이터처 승격 당시 인력 수치(689명에서 699명, 국가데이터관리본부 102명, 실무 4명 지적). newspim.com
- 17.뉴스핌 · 글로벌이코노믹(2026-10-21) — 2절의 상하이 데이터그룹 등록자본 50억 위안, 푸젠 빅데이터그룹 100억 위안.
학술
- 18.Bommasani, R. et al. "Picking on the Same Person: Does Algorithmic Monoculture lead to Outcome Homogenization?" NeurIPS 2022 — 6절 표 첫 줄의 구성요소 공유 가설과 학습 데이터 공유의 효과. arXiv:2211.13972
- 19.Bommasani, R. et al. "Algorithmic Monocultures in Hiring"(2026) — 6절 표 둘째 줄의 지원자 300만 명·지원 400만 건 규모 실증. 채용과 배분 맥락이라는 한계를 본문에 함께 적었다. arXiv:2605.27371
- 20.Longpre, S. et al. "The Data Provenance Initiative: A Large Scale Audit of Dataset Licensing & Attribution in AI"(2023) — 6절과 7.3절의 라이선스 누락 72% 이상, 오류율 50% 이상. arXiv:2310.16787
- 21.Longpre, S. et al. "Consent in Crisis: The Rapid Decline of the AI Data Commons" NeurIPS 2024 — 6절의 C4 핵심 출처 28% 이상 차단, 뉴스 도메인 거의 45%. arXiv:2407.14933
- 22.Shumailov, I. et al. "AI models collapse when trained on recursively generated data" Nature 631, 755–759(2024) — 6절의 모델 붕괴. doi.org
- 23.Tirumala, K. et al. "D4: Improving LLM Pretraining via Document De-Duplication and Diversification" NeurIPS 2023 — 6절의 학습 효율 20%, 16개 과제 평균 최대 2% 개선.
- 24.Common Crawl 소개 문서 및 Mozilla Foundation 2024년 연구 — 6절의 반례. 2019~2023년 공개 언어모델 47개 중 64% 이상이 걸러 낸 Common Crawl 기반이고 GPT-3는 학습 토큰의 80% 이상을 거기서 가져왔다는 수치는 이 연구를 인용한 보도 경유로 옮겼다. commoncrawl.org
페블러스 블로그 인접 글
- 25.같은 개정안의 예외 네 가지를 누가 판단하는지 따로 읽은 글 (4절)
- 26.관리는 잘해도 AI가 쓸 데이터는 모자란다는 공공데이터 평가 결과 (5절)
- 27.같은 학습데이터를 보도자료와 창구가 다르게 센 사례 (5절)
- 28.토큰을 GDP처럼 세는 나라 (3절)
- 29.개방됐다는 말과 학습에 쓸 수 있다는 말이 갈리는 자리 (5절)