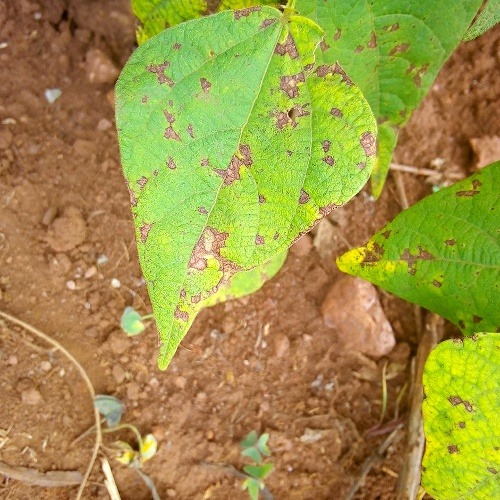
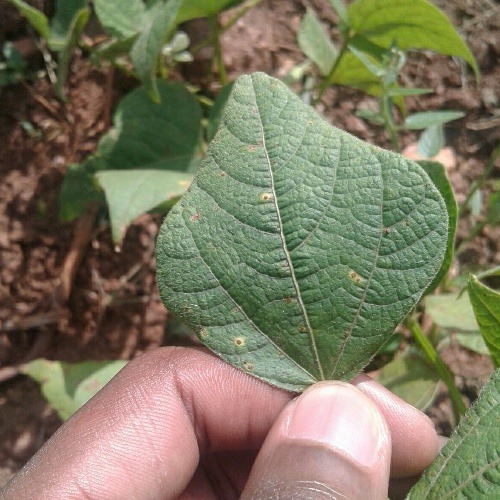
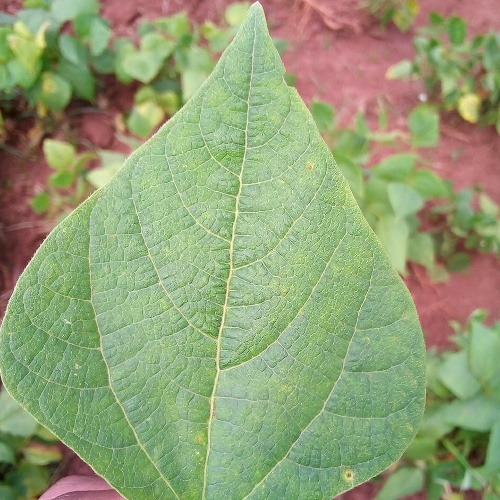
세 장은 최종 DINOv3 공간에서 고른 설명용 사례입니다. 클래스 전체의 대표성이나 병원체 확진을 뜻하지 않습니다. 데이터의 출처와 질병 이해하기
EXECUTIVE SUMMARY/ 핵심 요약
최신 비전 파운데이션 모델은 이미지들의 관계와 특징들을 어떻게 이해할까? 이 원리의 이해는 효과적인 합성 데이터 생성 및 데이터 다이어트 전략 수립에도 중요하다. 이 기사에서는 우간다 밭에서 촬영한 강낭콩 잎의 병변 데이터셋(iBean)을 예로 들어, DINOv3와 같은 최신 비전 파운데이션 모델이 어떻게 동작하고, 이에 기반해서 데이터 다이어트를 진행할 때의 효과를 살펴본다.
작성·검토일
질문·관측·실험 결과 자세히 읽기
질문
서로 다른 AI 모델은 이미지들을 어떻게 달리 볼까?
AI 학습 데이터는 복잡하고도 거대합니다. 이를 관찰 가능하고 측정 가능한 형태로 변환하는 것이 AI 학습 데이터 품질 관리의 시작입니다. 페블러스는 데이터 렌즈(DataLens)를 통해 이를 수행합니다. 비전 파운데이션 모델에 기반한 임베딩은 데이터 렌즈의 가장 중요한 접근법입니다.
AI의 발전에 따라 다양한 데이터 렌즈 후보들이 생기고 있습니다. 범용 파운데이션 모델도 있고, 도메인에 특화된 신경망도 있습니다. 이런 신경망들은 학습한 데이터, 학습 방법, 신경망 구조에 따라 데이터를 표현하는 방법과 구별력도 달라집니다.
이 기사는 Meta의 DINOv3를 중심으로 최신의 데이터 관찰 메커니즘을 살펴봅니다.
모무늬병·녹병의 두 가지 질병과 건강 상태, 총 세 가지 클래스로 분류되는 강낭콩 잎 사진 데이터셋(iBean)의 적용을 예로 들겠습니다. 그중 300장의 이미지를 네 가지 AI 모델로 바라볼 때, 각 모델이 사진에서 추출하는 특징값들을 분석합니다. 같은 AI 모델에서 서로 다른 이미지들이 실제로 어떻게 달리 표현되는지, 다른 AI 모델이 같은 이미지를 어떻게 달리 보는지를 비교합니다.
이 차이의 이해는 AI 학습에 사용할 데이터의 볼륨을 최적화하는 ‘데이터 다이어트’ 전략을 수립하는 데도 필수적입니다.
관측
AI가 만든 숫자를, 다시 이미지와 연결해 봅니다
데이터 렌즈는 사진을 수많은 숫자로 이루어진 특징값, 즉 임베딩으로 변환합니다. 그러나 숫자만으로는 그 특징이 무엇을 담고 있는지 알기 어렵습니다. 이 기사에서는 원본 사진과 특징값을 함께 보며, 사람이 보는 이미지의 차이가 AI의 표현 공간에서는 어떻게 나타나는지 살펴봅니다.
먼저 강낭콩 잎 사진 300장의 관계를 비교합니다. 사진 한 장을 선택하면 각 데이터 렌즈의 관점에서 특징이 가장 비슷한 사진들을 확인할 수 있습니다. 사람이 보기에도 잎의 모양이나 병반이 닮았는지 살펴볼 수 있습니다. 또는 잎의 특징보다는 배경이나 색이 더 비슷한지 비교할 수도 있습니다. 같은 사진이라도 데이터 렌즈에 따라 이웃이 달라질 수 있는데, 이 차이 역시 중요한 관찰 대상입니다.
데이터 렌즈의 출력값을 관찰한 다음에는 내부의 동작을 들여다봅니다. 모무늬병·녹병·건강으로 분류된 사진을 한 장씩 골라, 신경망의 각 층에서 정보가 어떻게 변환되는지 비교합니다. DINOv3의 ViT(이미지 트랜스포머) 데이터 렌즈라면, 입력 이미지가 작은 조각으로 나뉘고 각 층을 거치며 최종 임베딩으로 변환되는 과정을 따라갈 수 있습니다. 이번에 사용하는 DINOv3-L은 24개의 Transformer 블록을 거치며, 그 앞뒤의 입력 처리와 최종 정규화도 함께 살펴봅니다.
각 단계에서 실제로 기록한 숫자를 비교하면, 두 사진의 표현이 어느 구간에서 더 비슷해지고 어느 구간에서 더 달라지는지 확인할 수 있습니다. 이번 관찰은 개별 이미지들 사이의 표현 차이를 살펴보는 것입니다. 클래스 단위의 차이가 잘 표현되는지는 추후의 관찰 대상이며, 이 세 장만으로 클래스 전체에 대한 결론을 내리지는 않습니다.
사진 전체뿐 아니라 사진의 부분 단위로도 살펴봅니다. 별도로 특징값을 추출해 둔 여섯 장에서는 사진의 작은 영역을 선택하고, 같은 사진 안의 다른 영역과 특징이 얼마나 비슷한지 확인할 수 있습니다. 이 부분 단위의 특징 지도로 이미지 부분들 사이의 관계를 측정하고 비교합니다. 이 지도는 특징의 유사도를 나타내며, AI의 주의 집중이나 판단 원인을 직접 보여 주는 것은 아닙니다.
관측의 목적은 AI가 사람처럼 무엇을 이해했다고 단정하는 데 있지 않습니다. 어떤 이미지들이 어떤 표현에서 비슷해지고 달라지는지, 그 차이를 실제 사진과 수치로 확인하는 데 있습니다. 이러한 관측은 데이터 렌즈의 특성을 이해하고, 데이터 품질 개선 시 전체 데이터 분포상의 유의 영역, 즉 중점적으로 살펴볼 영역을 설정하는 데 도움이 됩니다. 예를 들어 데이터 다이어트에서 남긴 사진과 제거한 사진이 각각 어떤 특징과 이웃 관계를 갖는지 비교하며, 데이터 선택이 적절했는지 검토할 수 있습니다.
실험 결과
데이터 다이어트의 핵심, 무엇을 남기고 무엇을 뺄 것인가?
데이터 렌즈를 통한 AI 데이터의 관찰은 그 자체만으로도 매우 흥미로운 과정입니다. 하지만 데이터의 품질을 개선하고 AI의 성능과 개발 과정의 효율을 높이는 데도 사용될 수 있습니다.
대표적인 데이터 개선 방법인 데이터 다이어트에서는 데이터를 얼마나 줄이느냐뿐 아니라 무엇을 남기느냐 또한 중요합니다. 이번에 살펴보는 실험에서는 강낭콩 잎 사진 300장을 120장(40% 유지)으로 줄이는 과정을 관찰해 봅니다.
이미지 데이터를 DINOv3-L의 특징 공간으로 표현하고, 특별한 선별 방법(H 알고리즘)을 적용했습니다. 이 방법과 더불어 클래스별 사진 수를 동일하게 맞춰 무작위로 고른 경우를 비교했습니다. 남긴 데이터로 별도의 분류기를 학습하고, 학습에 사용하지 않은 사진으로 평가했습니다.
DINOv3-L 특징 공간 · 기존 반복 실험 평균
학습 데이터 구성
사진 수
평균 균형 정확도
전체 데이터 사용
300장
96.83%
H 알고리즘으로 선택
120장
95.24%
클래스별 수를 맞춰 무작위 선택
120장
91.89%
균형 정확도는 각 클래스의 사진을 올바르게 분류한 비율을 같은 비중으로 평균한 값입니다. H 알고리즘으로 선택한 경우는 같은 수의 무작위 선택보다 평균 3.35%포인트 높았습니다. 다만 300장 전체를 사용한 결과보다 높아진 것은 아닙니다.
이 결과는 데이터의 양뿐 아니라 선택 방법도 학습 결과에 영향을 줄 수 있음을 보여 줍니다. 그러나 다른 데이터 렌즈에서도 동일한 이점이 나타난 것은 아닙니다. 어떤 표현 공간에서 어떤 데이터를 남겼는지, 그리고 어떤 조건으로 평가했는지를 함께 살펴봐야 합니다.
데이터가 만들어진 이유와 사진 밖의 맥락을 알아야, 임베딩의 분리를 올바르게 읽을 수 있습니다.
농가의 현장 진단을 돕기 위한 iBean
Makerere AI Lab과 우간다 국립작물자원연구소(NaCRRI)가 우간다 여러 지역의 밭에서 스마트폰으로 수집했습니다. NaCRRI 전문가가 수집 현장에서 잎의 상태를 분류했습니다. 2020년 공개된 원 프로젝트의 목표는 농민이 현장에서 사용할 수 있는 강건한 모바일 병해 분류 모델입니다. 이는 데이터 공개의 목표이며, 현장 강건성이 이미 입증되었다는 뜻은 아닙니다.
여기서 beans는 대두가 아니라 common bean, 강낭콩류(Phaseolus vulgaris)입니다. 잎의 병반, 잎맥, 색과 질감뿐 아니라 배경·조명·촬영 각도도 함께 담긴 현장 사진입니다.
버전 주의: 원저자 README의 클래스 수 합계는 1,296장입니다. 배포 카탈로그의 1,295장과 1장 차이가 있으며, 이번 작업에서 그 원인은 확인하지 못했습니다.
어떤 연구에 쓰였나?
iBean을 활용한 경량 분류 모델.2022년 IEEE Access의 MobileNet 연구는 iBean으로 MobileNet·MobileNetV2를 학습·비교하고, 시험 이미지 128장에서 분류 정확도 92.97%를 보고했습니다. 모바일 기기에 적합한 경량 신경망을 사용한 사례이지만, 이 논문에서 실제 스마트폰 앱 배포나 다양한 농가 환경에서의 현장 검증까지 확인된 것은 아닙니다.
iBean을 활용한 Transformer 연구.2025년 Frontiers in Plant Science 연구는 iBean 1,295장으로 주파수 기반 전처리와 Transformer 병해 분류를 평가했습니다. 이처럼 iBean은 공개 병해 이미지 분류 벤치마크로 활용됩니다.
실제 모바일 앱까지 구현한 관련 연구 — 데이터셋은 구분.2024년 Makerere 연구진의 BeanWatchNet 연구는 분류 모델과 YOLOv8 탐지 모델을 스마트폰 앱과 Raspberry Pi에 탑재했습니다. 잎이 아닌 사진을 위한 ‘알 수 없음’ 클래스와 적대적 학습도 도입했습니다. 다만 이 연구는 15,335장의 별도 Makerere 콩잎 데이터셋을 사용했습니다. 이를 우리가 사용하는 2020년 iBean 소규모 공개본의 성과로 혼용하지 않습니다. 연구 코드 보기
시험 정확도와 현장 강건성은 다릅니다. 강건성은 농장·계절·휴대폰·조명·배경이 달라져도 성능을 유지하는지를 뜻합니다. 경량 모델의 학습, 앱 구현, 현장 강건성의 검증은 서로 다른 단계입니다. 확인한 공개자료만으로 iBean 공개본을 사용해 이 모든 단계가 입증되었다고 단정하지 않습니다.
우리는 새 진단 모델의 순위를 매기기보다, 고정된 임베딩 공간·층별 표현·H 표본 선택이 어떻게 달라지는지 연구합니다. 외부 논문의 정확도와 이 실험의 균형 정확도는 지표·분할·학습·평가 조건이 달라 직접 비교하지 않습니다.
모무늬병·녹병·건강, 세 분류의 의미
이 데이터셋은 강낭콩 잎 사진을 모무늬병, 녹병, 건강의 세 가지 상태로 분류합니다. 아래에서는 실제 사진과 함께 각 질병이 무엇이며 잎에 어떤 특징이 나타나는지 살펴봅니다. 사진 아래의 탐색 버튼을 누르면, 해당 사진과 AI가 비슷하다고 표현한 이웃 사진들도 비교할 수 있습니다.
사진 선정 기준과 한계 각 사진은 이번 실험의 DINOv3 특징값을 기준으로, 같은 분류의 평균에 가장 가까운 사례를 한 장씩 고른 것입니다. 각 분류의 다양한 모습을 모두 보여 주지는 않습니다. 질병 이름은 데이터셋에 기록된 분류이며, 이번 분석에서 병원체를 새로 확인한 것은 아닙니다.
#094 / ANGULAR LEAF SPOT
모무늬병 — 잎맥 사이의 각진 병반
Pseudocercospora griseola라는 곰팡이가 원인입니다. 잎맥에 막혀 각진 회갈색 병반이 생길 수 있고, 병이 심해지면 잎이 일찍 떨어져 생산에 영향을 줍니다. 같은 이름의 오이 세균병과는 다릅니다.
관찰 질문: 가까운 이웃도 병반의 형태를 공유할까요, 아니면 잎·배경의 색이 더 비슷할까요?
AI의 결과를 해석하려면, 먼저 그 결과를 만든 사진들이 어떤 데이터인지 알아야 합니다. 이 절은 데이터에 ‘좋다’ 또는 ‘나쁘다’는 점수 하나를 붙이기보다, 이번 실험에서 무엇을 확인했고 무엇을 더 확인해야 하는지 설명합니다.
예를 들어 같은 잎을 비슷하게 찍은 사진이 학습용과 시험용에 함께 들어 있다면, AI가 낯선 잎도 잘 구별하는 것처럼 보일 수 있습니다. 병반보다 배경이나 조명의 차이가 분류에 도움이 되었을 가능성도 살펴봐야 합니다. 이런 문제는 정확도가 높다는 사실만으로 해결되지는 않습니다.
여기서는 페블러스의 데이터 진단·개선 환경인 Data Greenhouse에 남아 있는 과거 진단 기록과 현재 사진 목록을 함께 읽습니다. 아래 내용은 기존 부분집합에 관한 확인이며, 공개본 전체 1,295장을 새로 진단한 결과가 아닙니다. 과거 기록에 쓰인 AI 모델과 평가 조건도 현재의 DINOv3 실험과 구분합니다.
분류와 구성
사진의 이름과 수는 믿을 만한가?
수집 기관의 설명에 따르면 전문가가 잎의 상태를 분류했습니다. 현재 탐색기의 사진은 모무늬병·녹병·'건강'이 각각 100장입니다. 비교를 시작하기 좋은 구성이지만, 분류가 모두 정확하다거나 사진 수가 같으니 모습도 충분히 다양하다는 뜻은 아닙니다. 서로 다른 파일이라도 같은 잎을 비슷하게 찍은 사진일 수 있습니다.
AI가 보는 차이
세 분류를 구별할 단서는 있는가?
과거 진단에는 사진에서 추출한 특징값으로 세 분류를 구별할 수 있다는 결과가 있습니다. 이런 구별 정도를 ‘분별성’이라고 부릅니다. 다만 기록마다 모델과 평가 조건을 함께 확인해야 하며, 이 수치를 현재 DINOv3의 품질 점수로 옮겨 쓸 수는 없습니다. 병든 부위를 근거로 구별했다는 증거도 아닙니다.
아직 확인할 부분
새 농장 사진에도 통할까?
같은 식물이나 비슷한 촬영본이 학습용과 시험용에 나뉘어 들어갔는지, 전문가들이 같은 사진에 같은 이름을 붙이는지, 다른 농장·휴대폰·조명에서도 결과가 유지되는지는 추가 확인이 필요합니다. 이를 모두 검증한 데이터나 현장 진단 서비스로 받아들이지는 않아야 합니다.
다음 탐색기는 이런 질문을 실제 사진으로 살펴보기 위한 도구입니다.이미지와 이웃을 비교하면서 병반·잎 모양·배경 중 무엇이 닮았는지 관찰해 보세요. 비슷한 사진이 모였다는 이유만으로 중복이라 단정하거나, 드문 사진이라는 이유만으로 제거해서는 안 됩니다. 이 관찰은 데이터 다이어트에서 무엇을 남길지 결정하기 전에 중점적으로 살펴볼 대상을 찾는 출발점입니다.
과거 진단 수치와 해석상의 주의점 보기
이 숫자들은 종합 품질 점수가 아닙니다. 분별성은 특징값으로 분류를 얼마나 구별할 수 있는지, 밀도는 특징 공간에서 주변 사진들이 얼마나 모여 있는지를 살펴보는 지표입니다. 높거나 낮다는 이유만으로 데이터가 좋다거나 나쁘다고 결론 내릴 수 없고, 계산 방법과 목적을 함께 봐야 합니다.
과거 품질 HTML은 분별성 92.19%·밀도 0.393±0.122·GOOD을, 별도의 Govern 보고서는 DINOv2-base 분별성 93.75%·5-fold CV 89.72±2.25%를 기록합니다. 5-fold CV는 데이터를 다섯 부분으로 나누어 평가 부분을 바꿔 가며 확인하는 교차 검증입니다. 기록별 조건이 달라 수치를 하나로 합치지 않습니다. 특히 과거 밀도의 정확한 정규화 기준은 이번에 복원하지 못했습니다.
Govern의 라벨 셔플 30회 평균은 35.89%, 보고된 p값은 0.0323입니다. 라벨 셔플은 사진의 분류 이름을 무작위로 섞은 경우와 비교하는 검사입니다. 이는 해당 검사에서 라벨과 특징의 연관 신호가 있다는 근거이며, 모든 누수 가능성을 배제하지 않습니다. 원시 반복 실행은 이번에 재현하지 않았습니다.
현재 저장된 cross-eval JSON의 DINOv2-base 자체 공간에서는 300장 93.75%, 253장 선택 92.19% 대 무작위 95.31%(차이 −3.12%p)입니다. 2026-08-15 권고는 유지 비율 0.843·BAD/caution을 기록합니다. 과거 품질 HTML의 ‘85.7% 감량 여력·GOOD’과 하나의 일관된 권고로 합칠 수 없습니다.
이 cross-eval은 기존 감사 기록상 로지스틱 회귀·accuracy·단일 무작위 선택 조건입니다. 아래의 MLP·균형 정확도·반복 seed·클래스 수를 맞춘 H 실험과는 다른 실험입니다. 두 기록의 300장이 현재 웹과 파일 단위로 같은 집합인지는 미확인입니다.
또한 2026-07-10 정정 원장은 일부 beans 파생셋의 ‘lens_diet’ 표기가 실제 층화 무작위 절삭이었다고 정정합니다. 그 결과를 정밀 H 선택의 증거로 가져오지 않습니다. 이번 변경은 운영 데이터나 과거 기록을 덮어쓰지 않습니다.
사람은 잎의 모양이나 색, 병반을 보며 사진이 닮았는지 판단한다. AI 모델은 사진을 숫자로 이루어진 특징값, 즉 ‘임베딩’으로 바꾸어 비교한다. 이 탐색기에서는 강낭콩 잎 사진 300장을 네 가지 데이터 렌즈(DataLens)로 살펴보며, 숫자로 측정한 유사도를 실제 사진과 연결해 본다.
아래 3차원 지도의 점 하나는 사진 한 장이다. 수많은 특징값의 관계를 한눈에 살펴볼 수 있도록 세 개의 좌표로 요약한 것이다. 사진을 선택하면 원본과 함께 특징값이 가장 비슷한 여덟 장을 볼 수 있다. 여기서는 이 사진들을 ‘이웃’이라고 부른다.
이렇게 살펴본다
사진 한 장 고르기
지도에서 점을 누르거나 ‘사진 선택’ 목록에서 사진을 고른다. 원본 이미지를 누르면 크게 볼 수 있다.
이웃 사진과 비교하기
선택한 사진과 이웃 여덟 장에서 잎 모양·병반·배경이 어떻게 닮았는지 살펴본다. 이웃 사진을 누르면 그 사진을 기준으로 지도와 상세 정보가 함께 바뀐다.
같은 사진을 다른 렌즈로 보기
사진을 선택한 채 DINOv2-L·DINOv3-L·SigLIP2·C-RADIOv4-H 버튼을 바꿔 본다. 사진은 그대로 두고, 모델에 따라 이웃과 배치가 어떻게 달라지는지 비교한다.
관찰할 질문은 ‘AI가 비슷하다고 표현한 사진이 사람의 눈에도 닮았는가?’이다. 병반보다 배경이나 색이 더 비슷한 경우도 찾아볼 수 있다. 이런 비교는 데이터 품질을 개선하거나 데이터 다이어트에서 무엇을 남길지 검토할 때, 더 자세히 살펴볼 대상을 찾는 출발점이다. 이웃이라는 사실만으로 같은 질병이나 중복 사진이라고 단정하지 않는다.
지도와 선택 상태를 읽는 기준
3D 지도는 특징값의 일부 관계만 담는다. 이웃 여덟 장은 화면상의 거리가 아니라, 요약하기 전의 전체 특징값으로 계산한다. 화면의 ‘cosine 유사도’는 두 특징 벡터의 방향이 얼마나 비슷한지 나타내며, 같은 렌즈 안에서는 값이 클수록 더 비슷하다. 질병일 확률이나 진단 확신도를 뜻하지 않는다.
점의 색은 데이터셋에 기록된 모무늬병·녹병·건강 분류다. AI가 새로 예측한 병명이 아니다. 렌즈마다 지도의 좌표축도 다르므로, 렌즈를 바꿀 때 점이 움직이는 모습을 하나의 공통 좌표계 안의 이동으로 해석하지 않는다.
‘보존·제거·경계 보호’는 기존 H 데이터 다이어트 실험에 저장된 선택 상태다. 여기서 원본 사진을 삭제하거나 선별 알고리즘을 다시 실행하는 것은 아니다. ‘제거’가 나쁜 사진이라는 뜻도 아니며, 이웃 목록만으로 선택 이유 전체가 설명되는 것은 아니다.
300장 모두 원본과 이웃을 탐색할 수 있다. 더 깊이 살펴보는 실제 패치 자료는 여섯 장, 층별 텐서 자료는 세 장에만 있다. 해당 사진을 선택하면 아래 ‘다음 탐색’ 영역의 연결 링크가 함께 바뀐다.
직접 탐색
렌즈와 사진을 고르고, 원본·선택 결과·이웃을 함께 비교한다.
DataLens동일 표본 · 렌즈별 비교
실험 데이터를 불러오는 중…3D / PCA
드래그 회전 · 휠 확대 · 점 클릭
고차원 이웃 8
cosine 유사도 순 · 자신 제외
모무늬병녹병건강
좌표는 렌즈별 L2 정규화 → 중심화 → PCA. 선은 원공간에서 정확히 계산한 상위 8개 cosine 이웃입니다. 3D 거리와 원공간 거리는 같지 않으며, 렌즈 간 축도 정렬하지 않았습니다.
데이터를 불러오지 못했습니다. 페이지를 새로고침해 주세요.
장면 02 · 같은 사진, 다른 이웃
모델을 바꾸면, 이웃도 바뀔까요?
각 행은 같은 사진에서 출발합니다. 왼쪽부터 원공간 cosine 유사도가 높은 이웃 8장입니다.
기존 이웃 자료를 준비하고 있습니다.
사진을 누르면 해당 모델과 사진으로 3D·상세·이웃 선택이 함께 바뀝니다. 유사도는 질병일 확률이 아닙니다. 모델 사이 점수를 같은 척도의 품질 점수로 비교하지 않습니다.
패치 지도는 두 이미지의 같은 격자 위치를 비교합니다. 같은 잎 부위라는 보장은 없습니다. attention이나 인과적 설명이 아니며, 아래의 ‘한 이미지 내부 패치 유사도’ 및 ‘합성 Gram 실험’과 분석 대상이 다릅니다. 기존 3D는 최종 CLS의 보조 투영입니다. 층마다 별도로 만든 3D 좌표를 연결하지 않았습니다.
기존 beans 실험에서 300장 중 120장을 남겼습니다. H와 같은 클래스 구성의 무작위 선택을 비교하자, 평가에 사용하는 렌즈에 따라 차이가 달랐습니다. 이 결과는 DINOv3 전체의 우열 순위가 아닙니다.
H − 무작위 선택의 Balanced Accuracy 기존 로컬 실험 · %p
점은 평균, 선은 95% 교차 부트스트랩 구간입니다. 같은 렌즈로 선택하고 평가한 self-space 결과. 선택 seed 3개 × 학습 seed 3개, 10,000회 재표집. raw 특징을 입력으로 하는 MLP로 평가했으며, held-out 128장 중 검증 65장·최종 평가 63장을 사용했습니다. 구간은 테스트 표본이나 데이터셋 간 불확실성을 모두 나타내지는 않습니다.
DINOv3-L의 평균 차이는 +3.35%p입니다. 그러나 선택 결과를 다른 렌즈에서 평가한 경우에는 음의 차이도 있었습니다. ‘Gram anchoring 때문에 H가 좋아졌다’는 인과적 주장은 이 실험만으로 할 수 없습니다.
10 / FROM EXPLORATION TO EXPLANATION
설명은 그림이 아니라, 추적 가능한 연결입니다.
점이 가까워 보인다는 인상에서 멈추지 않고, 어떤 표현과 거리, 어떤 선택 규칙이 결과를 만들었는지 돌아갈 수 있어야 합니다.
01
표현의 출처
이미지 ID · 전처리 모델 revision · 토큰 정책
02
원공간의 관계
FAISS 후보 생성 정식 H 커널로 재정렬
03
선택의 근거
OOF hardness · 밀도 경계 · 중복 · 보호 규칙
04
결과의 검증
보존 / 제거 이력 무작위 대조 · 교차 렌즈 평가
연구 워크벤치가 추적해야 할 개념적 증거 사슬입니다. 이 교육용 리포트는 고차원 cosine 이웃과 저장된 선택 결과를 보여 주며, FAISS/H 재실행이나 개별 결정의 전체 근거 추적 기능을 구현한 것은 아닙니다.
PebbloScope와의 역할 경계
Pebblous가 개발하는 PebbloScope의 API 저장소에서는 데이터셋 카탈로그, 2D/3D PCA 시각화 자산, 노드 미리보기, 색 매핑, 스냅샷 기능을 확인했습니다. 범용 공간 탐색은 이 계층을 재사용하고, Data Clinic 연구 워크벤치는 H의 의사결정·실험 근거를 책임지는 구분이 적절합니다.
검토 기준: 저장소 로컬 체크아웃 d39926d. 실제 서비스의 현재 배포 API와 동일하다고 검증한 것은 아닙니다. 이 리포트는 교육용 독립 산출물이며 PebbloScope나 기존 Data Clinic의 운영 기능을 대체·수정하지 않습니다.
11 / METHODS & SOURCES
무엇을 관찰했고, 무엇을 가정했는가.
실측 데이터, 원리 설명 모형, 연구 해석을 구분했습니다. 300장 원본·기존 CLS·기존 6장 패치 특징을 재사용했습니다. 층별 탐색은 기존 환경에서 3장과 반복 확인 1회만 추가 추론했습니다. 새 학습·다운로드·전체 재추론은 없습니다.