Executive Summary
이 글은 2026년 10월 7일 arXiv에 올라온 TouchScale 논문을 읽는다. 스물여섯 명이 이름을 올린 이 논문이 내놓은 것은 새 모델이 아니라 데이터셋이다. 사람이 양손에 촉각 장갑을 끼고 물건을 만지는 동안 머리에 쓴 카메라와 손목 카메라가 같은 시간축으로 돌아간 기록 500시간이다.
저자들이 앞선 데이터셋의 약점으로 지목한 것은 분량이 아니었다. 큰 자료일수록 서로 다른 센서와 서로 다른 주석 절차로 모은 기록을 합쳐 놓은 탓에, 성능이 올랐을 때 그것이 양 덕분인지 장비 덕분인지 가를 수 없었다. 그래서 장비와 절차를 한 종류로 고정했다. 그 결과 처음 보는 촉각 센서를 상대로 한 접촉 예측 정확도가 0.134에서 0.383으로 올랐는데, 이 간격 안에는 성격이 다른 두 몫이 섞여 있다. 3절에서 그 둘을 갈라 본다.
1절부터 4절까지는 논문과 프로젝트 페이지, 그리고 본문에 따로 밝힌 업계 출처에 적힌 사실이다. 5절은 그 사실을 피지컬 AI 데이터를 모으는 쪽의 눈으로 다시 읽은 이 글의 해석이다.
주요 수치
논문과 프로젝트 페이지에서 네 숫자를 뽑았다. 앞의 둘은 모은 기록과 장비의 크기이고, 뒤의 둘은 그 기록으로 학습한 모델이 낸 값이다.
500시간
한 장비로 모은 촉각 기록
논문이 비교 대상으로 든 선행 데이터셋 중 가장 컸던 것이 37.2시간이다
880개
장갑 한 짝의 감지점
다섯 손가락과 손바닥에 흩어져 있고 공간 해상도는 2mm 아래다
0.134→0.383
처음 보는 센서의 접촉 예측 IoU
같은 16시간끼리 견주면 0.134 대 0.181이고, 나머지는 양이 올린 몫이다
22.5%→57.5%
로봇 작업 네 가지 평균 성공률
과제마다 시연 50번을 보여 주고 20번씩 시험한 결과다
영상은 쌓였는데 닿은 자리는 비어 있다
로봇에게 몸 쓰는 법을 가르치려는 연구자들은 지난 몇 해 동안 사람 시점 영상을 모았다. 사람이 주방에서 무엇을 어떻게 집는지 머리에 쓴 카메라로 찍어 두면, 그 화면이 로봇 정책을 학습시키는 재료가 된다는 생각이다. 논문의 첫 문단은 그 흐름을 인정하면서 한 가지를 덧붙인다. 영상만으로는 접촉과 압력이 기록되지 않는다는 것이다. 컵을 쥔 화면은 남지만 손가락 어디가 얼마나 눌렸는지는 남지 않는다.
그 빈자리를 메우려는 촉각 데이터셋은 이미 여럿 나와 있다. 다만 분량이 영상과 자릿수부터 다르다. 논문이 비교 대상으로 올린 것들을 보면 EgoTouch가 20시간, FEEL이 약 27시간, DeskTask-Tac이 37.2시간이고, OpenTouch는 5.1시간, EgoTactile은 5.82시간이다. 사람 시점 영상이 수천 시간 단위로 거래되는 자리에서 가장 큰 촉각 자료가 40시간에 못 미친다.
분량보다 저자들이 더 무겁게 짚은 것은 따로 있다. 규모가 큰 자료일수록 서로 다른 센서로 찍은 기록과 서로 다른 주석 절차를 거친 기록을 한데 합쳐 만들어졌다는 점이다. 그런 자료로 학습해 성능이 올랐다고 하면, 오른 이유를 설명할 방법이 없다. 데이터가 늘어서인지, 중간에 섞인 더 좋은 센서 때문인지, 주석 기준이 달라져서인지 구분할 수 없다. 논문의 표현을 그대로 옮기면 데이터 규모의 효과를 분리하기 어렵다.
같은 진단이 논문 밖에서도 나온다. 2026년 9월 피츠버그에서 열린 IROS 워크숍의 제목이 "Scalable Tactile Sensing for Dexterous Manipulation"이었고, 주최 측은 촉각이 로봇에 꼭 필요한데도 표준화와 보급에서 시각 쪽에 뒤처져 있다고 취지문에 적었다. 다만 그 뒤처짐을 메우는 방향은 갈린다. 한 갈래는 센서를 더 조밀하게 만드는 길이다. IEEE 스펙트럼이 전한 DAIMON Robotics의 촉각 센서는 손끝만 한 모듈 하나에 감지 단위를 11만 개 넘게 넣었다. 장갑 한 짝에 880개를 흩어 놓은 TouchScale과는 밀도의 자릿수부터 다르고, 겨냥하는 자리도 다르다.
이 지적은 촉각에만 해당하는 이야기가 아니다. 여러 출처를 합쳐 덩치를 키운 자료는 어느 분야에나 있고, 그런 자료 위에서는 "데이터를 더 모으면 좋아진다"는 흔한 전제조차 검증되지 않은 채로 남는다. TouchScale이 택한 해법은 더 좋은 센서를 만드는 쪽이 아니라 쓰던 장비를 하나로 묶고 절차를 손대지 않는 쪽이었다.
장비를 한 종류로 묶은 양손 장갑
수집에 쓴 장비는 착용형 한 벌이다. 장갑 한 짝에 880개의 감지점이 다섯 손가락과 손바닥에 흩어져 있고, 공간 해상도는 2mm 아래다. 감지점이 읽는 값은 수직 방향으로 누르는 압력이다. 무선으로는 초당 50번, USB-C 유선으로는 초당 100번 값을 받는다. 여기에 머리에 쓴 RGB-D 카메라와 양 손목에 붙인 RGB 카메라가 초당 30장으로 돌아가고, 세 갈래 기록이 같은 시간축에 정렬된다. 보는 것과 닿는 것이 한 줄로 묶인다는 뜻이다.
이 한 벌로 약 스무 명의 참가자가 500시간, 약 8만 7천 개의 에피소드를 남겼다. 작업 설명은 약 2천 가지이고, 아홉 개의 큰 수집 환경 아래 800개가 넘는 서로 다른 장면 구성이 들어 있다. 내용은 주방이나 작업대에서의 일상 동작부터 과제가 정해진 조작까지 걸친다. 이 전부를 같은 장갑, 같은 카메라 배치, 같은 절차로 모았다.
장비를 고정하면 자료 하나하나가 좋아지지는 않는다. 대신 자료들 사이를 비교할 수 있게 된다. 50시간짜리 부분집합과 500시간 전체를 나란히 놓고 학습시켰을 때 생기는 차이는 오직 양에서 온 차이다. 센서가 같고 절차가 같으니 다른 설명이 끼어들 자리가 없다. 논문의 실험 설계가 성립하는 근거가 여기에 있다.
▲ 페블러스 원본 도식. Source: Li et al., arXiv:2610.10288 (2026-10-07); TouchScale 프로젝트 페이지.
규격이 올린 몫과 양이 올린 몫
논문의 초록이 내세우는 문장은 접촉 예측 정확도가 0.134에서 0.383으로 올랐다는 것이다. 여기서 쓰인 지표 cIoU는 모델이 "여기가 닿았다"고 찍은 영역과 실제로 닿은 영역이 얼마나 겹치는지를 손의 열두 부위에 걸쳐 평균한 값이다. 1에 가까울수록 정확하다. 시험 방식은 제로샷이다. 학습에 한 번도 쓰지 않은 다른 촉각 센서, 구체적으로는 EgoTactile 데이터셋의 센서로 찍은 자료를 가져와 맞혀 보게 한다.
이 두 숫자를 그대로 읽으면 "데이터를 서른 배로 늘렸더니 세 배 가까이 정확해졌다"가 된다. 그런데 0.134는 TouchScale의 작은 부분집합으로 학습한 값이 아니다. EgoTouch 데이터셋의 학습 구간 전체, 16.2시간으로 학습한 모델이 낸 값이다. 다른 데이터셋이 바뀌었고 분량도 바뀌었으니, 두 숫자 사이의 간격은 한 가지 원인으로 설명되지 않는다.
저자들도 그 점을 알고 분량을 맞춘 실험을 따로 돌렸다. TouchScale에서 약 16시간만 떼어 내 EgoTouch의 16.2시간과 같은 조건으로 맞춘 것이다. 결과는 0.181이었다. 같은 분량에서 0.134와 0.181이 갈렸으니 이 0.047이 장비와 절차를 하나로 묶은 몫이다. 나머지 0.202는 그 규격을 유지한 채 분량을 500시간까지 늘려 얻은 몫이다. 초록의 한 줄이 가린 두 성분이 이렇게 나뉜다.
▲ 페블러스 원본 도식. 위의 두 값은 분량을 맞춘 비교 표에서, 아래 두 값은 데이터 비율을 10%에서 100%까지 늘린 별도 실험에서 가져왔다. Source: Li et al., arXiv:2610.10288, Table 2 및 Figure 4.
양을 늘린 몫도 한 덩어리가 아니다. 논문이 적은 비율별 값을 보면 전체의 10%, 그러니까 50시간에서 이미 0.311이 나왔고 거기서 500시간까지 열 배를 더 채워 0.383에 닿았다. 16시간에서 50시간으로 가는 구간이 0.13을 올린 반면, 50시간에서 500시간으로 가는 구간은 0.07을 올렸다. 커브가 오르기는 하되 뒤로 갈수록 눕는다. 두 수치가 서로 다른 실험에서 나온 값이라 한 곡선 위에 그대로 올려놓을 수는 없지만, 방향은 분명하다.
같은 표에 눈에 띄는 칸이 하나 더 있다. 각 데이터셋이 자기 자료의 평가 구간에서 자신을 맞히는 경우, EgoTouch는 0.403이고 TouchScale은 0.422다. 거의 붙어 있다. 두 자료의 격차는 자기 집에서가 아니라 처음 보는 센서로 넘어갈 때 벌어진다는 뜻이다. 수집 규격을 통일해서 얻는 것이 무엇인지가 이 대비에 들어 있다. 익숙한 자료를 더 잘 맞히는 능력이 아니라, 낯선 장비로 옮겨 갔을 때 덜 무너지는 능력이다.
인식 쪽 성적도 함께 나왔다. TouchScale로 영상 인코더를 사전학습시킨 뒤 행동 인식 벤치마크 세 가지(MECCANO, Something-Something V2, Ego-Exo4D)에서 재 보니, 비교한 비전-촉각 데이터셋들 가운데 평균 정확도가 가장 높았다고 논문은 적는다.
정작 평가 때는 촉각이 없다. 사전학습에서 모델이 받은 과제는 촉각을 맞히는 일이었지만, 성적을 재는 세 벤치마크는 촉각 기록이 없는 영상 자료다. 비교 대상도 같은 구조의 인코더를 OpenTouch, FEEL, EgoTouch로 똑같이 사전학습한 것들이라 달라진 조건은 사전학습에 쓴 자료뿐이고, 인코더를 얼린 채 분류기만 얹는 방식과 전체를 다시 학습시키는 방식에서 결과가 같은 쪽으로 기울었다. 닿는 것을 맞히며 익힌 표현이 장갑을 벗은 뒤에도 영상 안에 남았다는 뜻이 된다.
사람 손의 기록은 로봇 손에서도 통하는가
사람 손에서 모은 기록이 로봇에서도 쓸모가 있는지는 따로 확인해야 하는 문제다. 논문은 xArm6 로봇 팔에 BrainCo Revo 2 손을 붙인 장비로 네 가지 과제를 시켰다. 네 가지 모두 접촉이 많은 일이다. 과제마다 사람 시연 50번을 보여 주고, 학습이 끝난 뒤 20번씩 시도하게 해서 성공 횟수를 셌다.
비교 대상은 TouchScale을 중간 학습 단계에 끼워 넣은 정책과 그렇지 않은 정책이다. 과제별 결과는 다음과 같다.
| 과제 | 하는 일 | 기준 정책 | TouchScale 적용 |
|---|---|---|---|
| Soft/Hard Sorting | 무른 물건과 단단한 물건을 만져서 갈라 담기 | 10% | 60% |
| Bottle-Cap Removal | 병뚜껑 돌려서 열기 | 40% | 70% |
| Test-Tube Transfer | 시험관 집어 옮기기 | 30% | 60% |
| Whiteboard Wipe | 화이트보드 눌러 닦기 | 10% | 40% |
| 평균 | 22.5% | 57.5% |
▲ 네 과제 모두 과제당 시연 50회, 평가 20회 기준이다. Source: Li et al., arXiv:2610.10288; TouchScale 프로젝트 페이지.
눈금 하나가 5%p인 20회짜리 시험이라 과제별 값은 흔들림이 크다. 그래도 네 과제가 모두 같은 방향으로 움직였고, 가장 많이 오른 쪽이 무른 것과 단단한 것을 갈라 담는 과제였다는 점은 읽을 만하다. 물건을 보기만 해서는 무른지 단단한지 알기 어렵고, 눌러 봐야 알 수 있는 일이다. 촉각 기록이 가장 크게 기여할 법한 자리에서 실제로 가장 크게 올랐다.
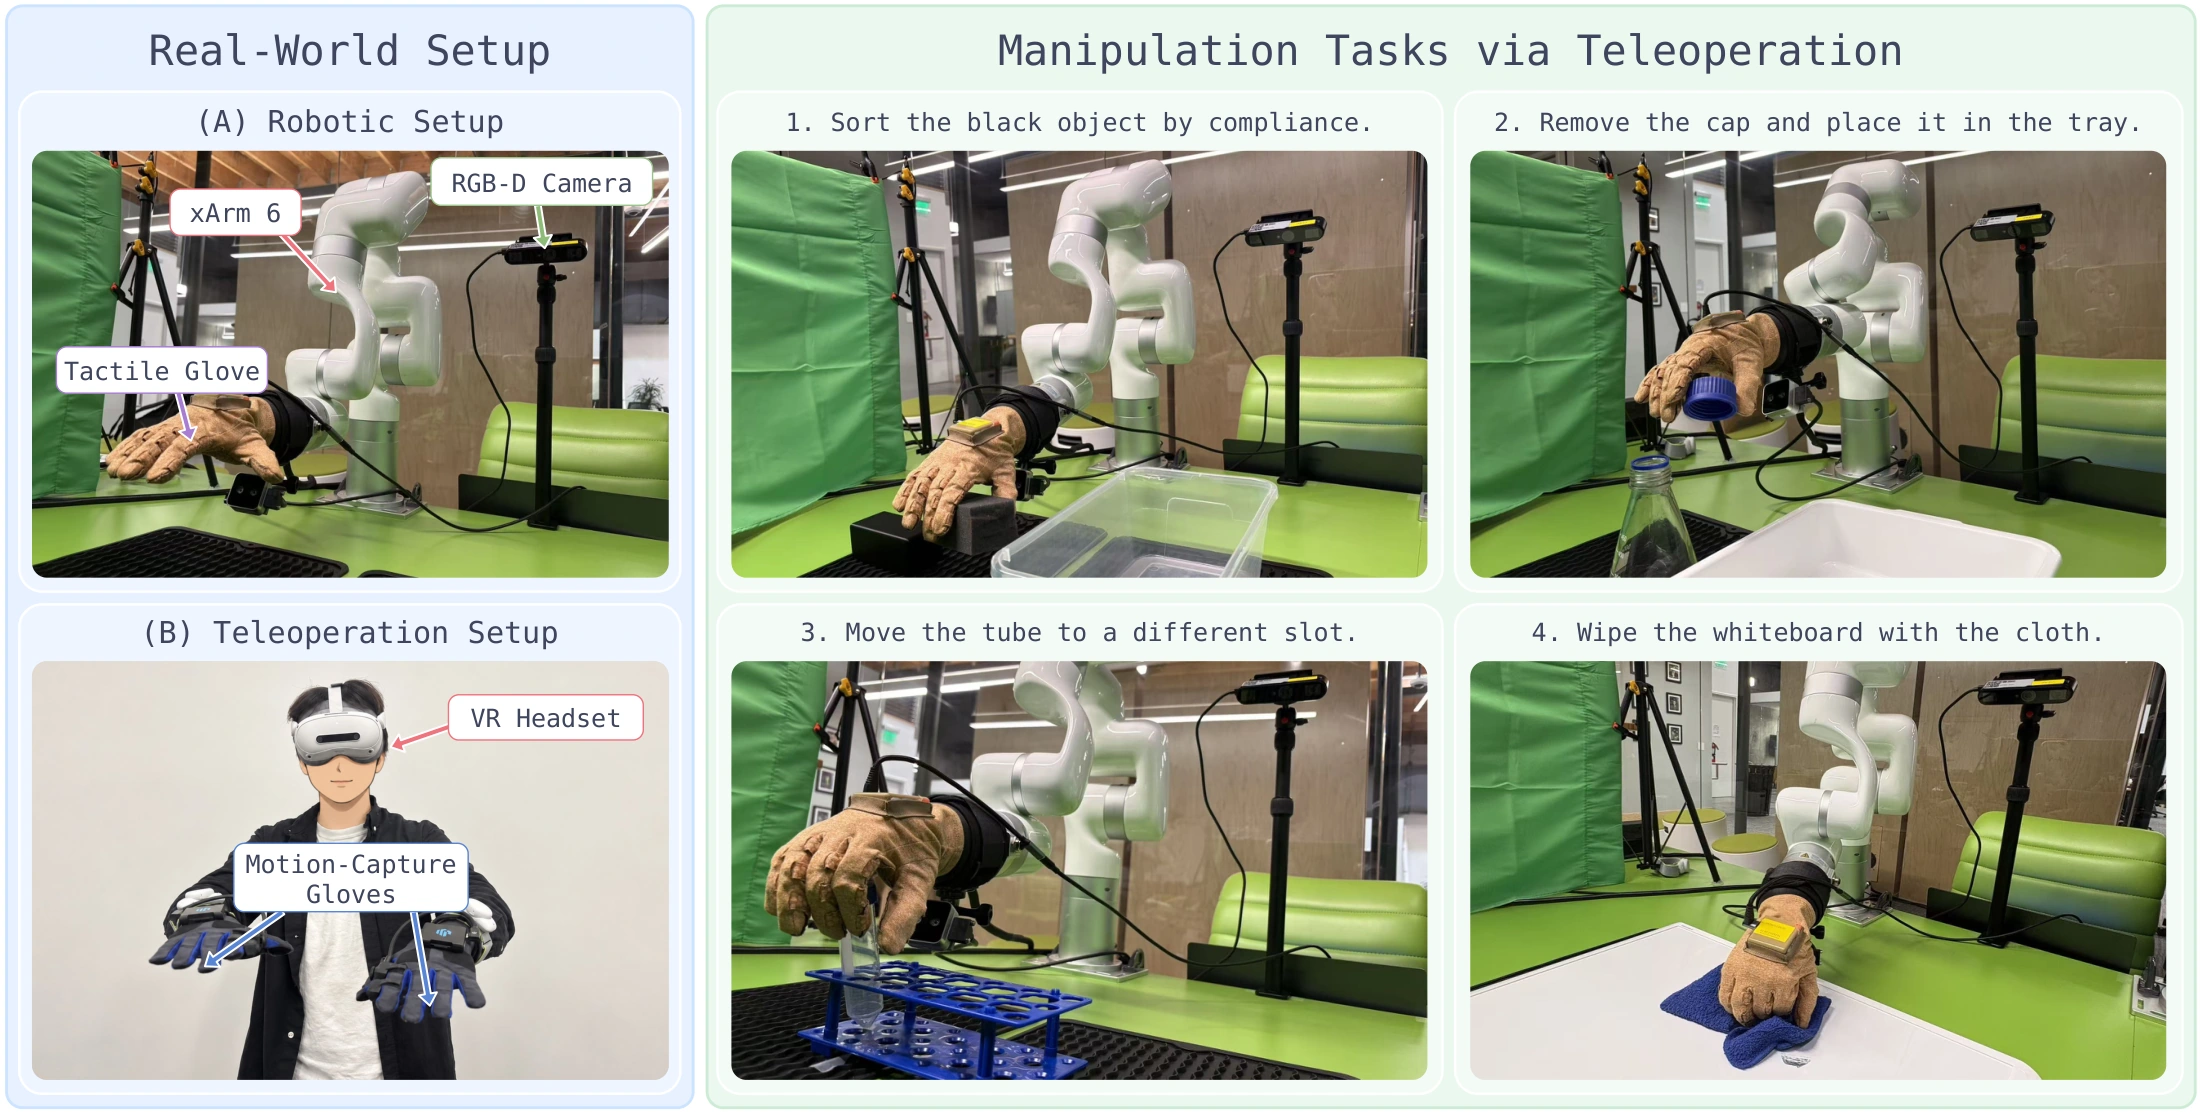
논문이 스스로 적은 한계도 함께 읽어야 한다. 로봇 평가는 플랫폼 하나와 과제 네 가지에 머물렀고, TouchScale에는 행동 라벨이 들어 있지 않다. 더 걸리는 것은 다음 순간의 촉각을 맞히는 오차와 다음 동작을 맞히는 오차 사이의 연관이 약하게만 관찰됐다는 대목이다. 촉각을 잘 맞히는 모델이 곧 잘 움직이는 로봇이 되는지를 저자들은 열린 질문으로 남겨 두었다.
논문이 이 결과에 붙인 결론은 조심스럽다. 센서와 수집 절차를 고정한 채 TouchScale 데이터를 더 쓸수록 제로샷 촉각 예측과 로봇 성공률이 전반적으로 오르는 추세를 보인다는 것이다. 모든 지점에서 단조롭게 오른다고는 적지 않았다.
페블러스가 이 데이터셋을 주목하는 이유
페블러스가 AI-Ready Data를 말할 때 되풀이하는 전제가 있다. 데이터의 값어치는 분량만으로 정해지지 않고, 그 데이터가 어떤 규격으로 모였는지가 함께 기록돼야 쓸 수 있는 자료가 된다는 것이다. 이 논문은 그 주장을 수치로 보여 주는 드문 사례다. 같은 16시간에서 0.134와 0.181이 갈렸다는 한 줄이, 규격을 맞추는 일이 공짜가 아니라 값으로 돌아온다는 뜻이기 때문이다.
순서도 함께 읽힌다. 수집 규격을 통일하는 일은 데이터를 많이 모으기 전에 끝내야 하는 일이다. 다 모은 뒤에는 되돌릴 수 없다. 서로 다른 장비로 쌓인 500시간은 아무리 많아도 "양을 늘려서 좋아졌다"는 말을 할 수 없는 자료로 남고, 그 자료를 쓰는 팀은 성능이 올라도 무엇을 더 해야 할지 알 수 없다. 데이터를 모으는 쪽이 이 논문에서 먼저 볼 대목은 500이라는 숫자가 아니라 "한 벌"이라는 조건이다.
다만 규격을 묶는 선택에도 대가가 따른다. 장갑을 끼고 모은 기록은 맨손으로 물건을 만지는 장면과 생김새가 다르다. TouchScale보다 3주 앞서 나온 TouchSight 논문이 바로 그 문제를 다룬다. 500시간 분량의 압력 장갑 기록을 쓰면서, 장갑 낀 손으로 학습한 모델을 맨손 영상에 그대로 들이댈 때 생기는 외관 격차를 메우려고 생성 모델로 맨손 장면을 다시 그린 20시간짜리 짝 데이터를 따로 만들었다. 한쪽을 고정하면 다른 쪽에 비용이 생긴다는 것을, 이 두 논문이 나란히 보여 준다.
쓰려는 쪽이 먼저 확인할 것도 하나 있다. 지금 허깅페이스에 올라와 있는 분량은 100시간, 15,324 에피소드, 929개 작업, 22개 장면 유형이다. 논문이 말하는 500시간, 약 8만 7천 에피소드와 다르다. 올라온 것은 일부 공개분이고, 라이선스는 CC BY-NC 4.0이라 상업적 사용에는 별도 허락이 필요하다. 논문의 수치를 근거로 들 때는 어느 쪽을 받아 쓰는지 구분해 두는 편이 안전하다.
여기까지 읽어 주셔서 감사하다. 이 글의 수치는 TouchScale 논문과 프로젝트 페이지에서 확인했다. 여러분의 팀은 데이터를 모으기 전에 무엇부터 하나로 맞추는지 나눠 주시면 좋겠다.
참고문헌
학술 논문
- 1.Li, D. 외 25인. (2026). "TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning." arXiv:2610.10288, 2026-10-07.
- 2.Zhou, D. 외 5인. (2026). "TouchSight: Bare-Handed Tactile Prediction from Egocentric Video via Generative Visual Augmentation." arXiv:2609.20414, 2026-09-17.
업계·데이터 소스
- 3.TouchScale Team. (2026). "TouchScale Project Page."
- 4.2077AI Data Foundation. (2026). "TouchScale: Egocentric Human Vision and Touch for Visual–Tactile Learning." Hugging Face, CC BY-NC 4.0.
- 5.Dutta, S. (2026). "DAIMON Robotics Wants to Give Robot Hands a Sense of Touch." IEEE Spectrum, 2026-05-04.
- 6.IROS 2026 Workshop Organizers. "Scalable Tactile Sensing for Dexterous Manipulation." IROS 2026, Pittsburgh, 2026-09-27.