Executive Summary
약물 후보가 단백질에 어떻게 달라붙는지를 계산하는 프로그램은 구조 데이터베이스에 적힌 원자 좌표를 입력으로 받는다. 그 좌표에 수소는 대체로 없다. X선은 전자에 부딪혀 튕기는 빛으로 원자 자리를 알아내는데, 수소는 전자가 하나뿐이라 신호가 너무 약하다. 단백질 결정의 해상도로는 수소가 어느 자리에 붙어 있는지까지 가려내지 못한다. 그래서 그 자리는 사람이 화학 지식으로 채워 넣는 것이 오래된 관행이다. 뉴욕대 화학과 연구진이 9월 23일 《케미컬 사이언스》에 실은 논문은 그렇게 채워 넣은 값을 대조해 볼 잣대를 만들었다. 이 글은 그 잣대가 무엇을 찾아냈고 무엇은 못 찾았는지를 본다.
연구진은 수소 위치가 실험으로 확인된 소분자 결정 12만여 개를 모아, 결정이 실제로 택한 형태를 안정으로 적고 프로그램이 같은 분자에서 뽑아낸 나머지 형태를 불안정으로 적어 113만 줄짜리 학습표를 만들었다. 그 모델을 단백질과 약물 후보가 붙어 있는 표준 데이터셋 PDBbind에 걸었다. 수소 자리가 여럿일 수 있는 리간드 5,075건 가운데 279건이 모델의 예측과 어긋났다. 그중 수소결합이 늘고 짝을 못 찾은 극성 원자가 줄어든 126건만 표기가 틀렸을 가능성이 크다는 쪽으로 남았다. 널리 인용되는 2.5%는 어긋난 전부가 아니라, 구조가 편을 들어 준 절반 이하다.
1절부터 4절까지는 논문에 적힌 내용이다. 5절은 그 내용에서 이 글이 끌어낸 해석이다.
주요 수치
출처: Pan 외, Chemical Science (2026) 본문 결과·표 1·표 2·표 3.
126 / 279
구조가 뒷받침한 재지정 후보
모델과 어긋난 리간드는 279건이고, 그중 수소결합이 늘고 짝 없는 극성 원자가 준 것이 126건이다
2.30 → 1.65
도킹 점수의 평균절대오차(kcal/mol)
126건의 수소 자리를 바꿔 다시 계산하자 실측 결합력과의 오차가 줄었다
12만 9,783
실험이 실제로 본 안정 토토머
학습표는 113만 1,426줄이지만, 그중 결정에서 관측된 형태는 이만큼이고 나머지는 프로그램이 만들어 내 불안정으로 적은 것이다
0.72
물속 기준 평가셋의 정밀도
다섯 평가셋을 합치면 0.88이지만, 수용액 하나만 떼어 재면 가장 낮은 값이 나온다
X선은 수소를 보지 못한다
단백질의 생김새를 알아내는 표준 방법은 X선 결정학이다. 단백질을 결정으로 키워 X선을 쏘면 전자에 부딪힌 빛이 특정 방향으로 몰려 나오고, 그 무늬를 거꾸로 풀어 전자가 짙은 곳에 원자를 하나씩 놓는다. 이 방법에는 태생적인 맹점이 하나 있다. 수소는 전자를 하나만 가진다. 다른 원자보다 되비치는 신호가 거의 없다시피 하고, 단백질처럼 큰 분자의 결정에서는 그 희미한 신호를 잡아낼 만큼 해상도가 나오지 않는 경우가 대부분이다.
그래서 단백질 구조 데이터베이스(PDB)에는 수소가 어디 붙어 있는지를 가려 줄 정보가 대체로 없다. 뉴욕대 발표문은 이 상태를 그대로 적는다. 토토머를 구별해 주는 수소 원자의 위치는 PDB에서 보통 이용할 수 없다는 것이다. 없으면 비워 두는 것이 아니라, 화학적으로 그럴듯한 형태를 골라 채운다. 그 선택이 곧 토토머 지정이다.
토토머는 분자식이 같은데 수소 하나가 자리를 옮기고 그에 맞춰 결합 패턴이 함께 바뀌는 형태들을 말한다. 종이 위에서는 사소해 보이는 차이다. 그런데 수소가 어디 붙어 있느냐에 따라 그 분자가 수소결합을 내주는 쪽인지 받는 쪽인지가 뒤바뀐다. 단백질 주머니 안에서 어느 잔기와 손을 잡을 수 있는지가 달라진다는 뜻이다. 교신저자인 잉카이 장 교수는 작아 보이는 변화지만 같은 분자의 토토머가 다르면 표적 단백질과 상호작용하는 방식이 달라진다고 설명했다.
여기서 걸리는 것은 그 지정이 어디로 흘러가느냐다. 도킹, 자유에너지 계산, 가상 스크리닝은 모두 이 좌표와 결합 패턴을 입력으로 받는다. 그리고 결합력 예측 모델을 학습시키고 채점하는 데 쓰이는 PDBbind 같은 파생 데이터셋도 같은 지정을 그대로 물려받는다. 사람이 고른 형태가 기계의 정답지가 되는 셈이다.
오해를 피할 필요가 있다. 이 연구가 단백질 구조가 틀렸다고 말하는 것이 아니다. 장 교수는 발표문에서 선을 분명히 그었다. "이것은 실험으로 결정된 단백질 구조 자체가 틀렸다는 뜻이 아니다. 우리 결과는 이전에 지정된 화학적 표현이 수정을 요할 수도 있음을 시사한다." 뼈대는 실험이 본 것이고, 그 뼈대 위에 얹힌 화학적 해석 한 겹이 재검토 대상이라는 이야기다.
수소가 보이는 결정을 교과서로 삼았다
수소를 본 적이 있는 실험 자료가 따로 있다. 작은 유기분자의 결정이다. 단백질보다 훨씬 작고 잘 정렬되기 때문에 해상도가 높게 나오고, X선으로도 수소가 잡히는 경우가 있다. 더 확실한 것은 중성자를 쓴 경우다. 중성자는 전자가 아니라 원자핵에 부딪히고, 수소의 핵은 중성자를 꽤 세게 튕겨 낸다. 전자가 하나뿐이라 X선으로는 놓치던 원자를 중성자로는 잡아낼 수 있다.
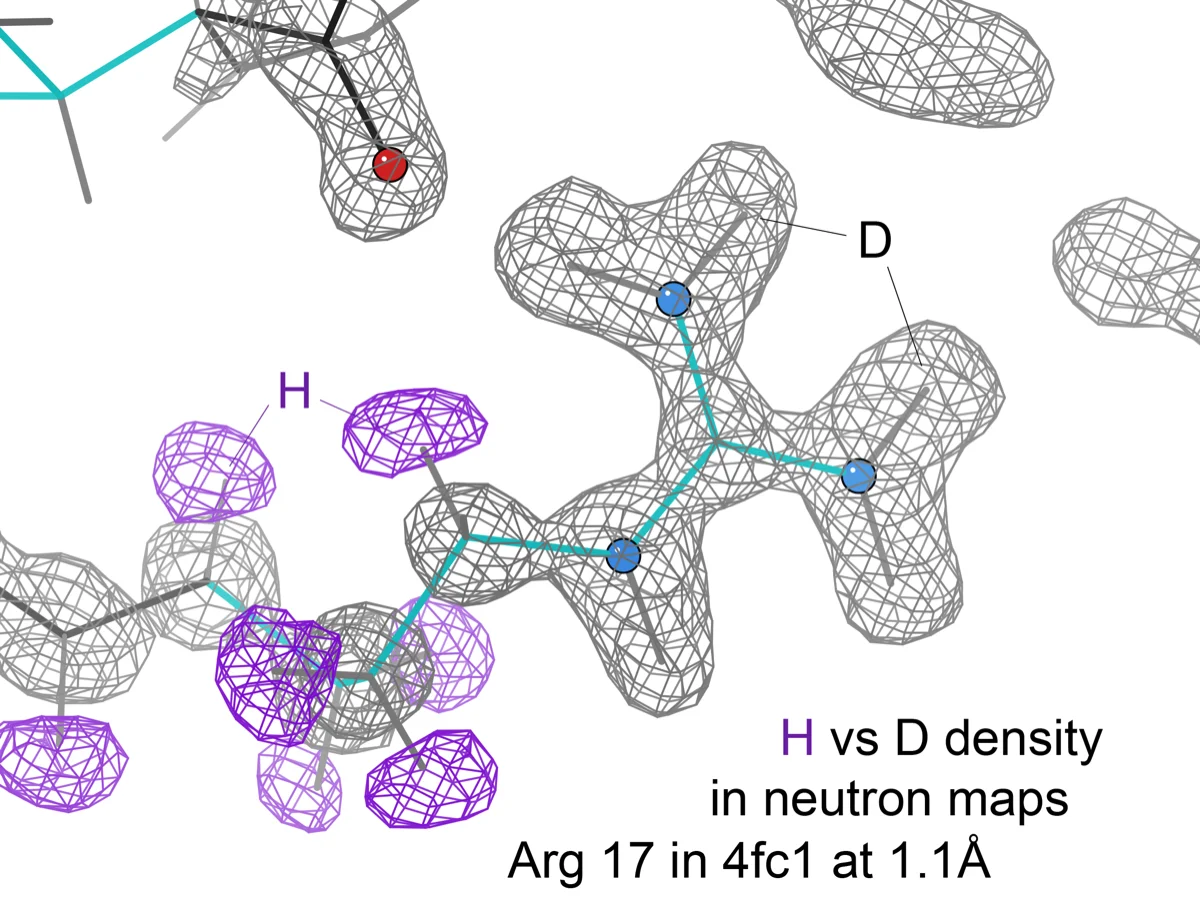
연구진이 고른 자료가 그것이다. 케임브리지 구조 데이터베이스(CSD)에는 수소 위치가 특히 믿을 만한 구조만 따로 추린 목록이 있고, 주로 중성자 회절로 결정된 것들이다. 이 목록의 구조를 전부 꺼내 분자식으로 바꾼 뒤, 깨진 분자와 전하를 띤 분자를 걷어내고 평가용으로 떼어 놓은 분자와 겹치는 것을 지웠다. 결정 안에서 수소가 실제로 어느 자리에 있었는지가 적혀 있으니, 그 결정이 어떤 토토머를 택했는지도 함께 적혀 있는 셈이다.
학습표의 크기를 읽을 때는 한 가지를 따져 봐야 한다. 논문 초록에 적힌 110만여 건은 실험이 본 형태의 개수가 아니다. 표 1에 그 내역이 있다. 분자는 128,868개, 그중 실험이 안정하다고 본 형태는 129,783건이다. 나머지는 같은 분자에서 프로그램이 기계적으로 펼쳐 놓은 다른 형태들로, 전부 불안정으로 적혔다. 그렇게 채운 학습표의 총 줄 수가 1,131,426이다. 정답 쪽 한 줄에 오답 쪽 여덟 줄 가까이가 붙어 있는 셈이다. 논문이 출처로 적은 곳도 CSD 목록 하나가 아니라, 물속 토토머 비율을 실은 실험 데이터베이스 두 곳이 함께 들어간다.
정답표를 만드는 규칙은 단순했다. 분자마다 가능한 토토머를 프로그램으로 전부 늘어놓고, 결정에서 관측된 형태 하나만 안정으로 적고 나머지는 모두 불안정으로 적었다. 논문은 이 규칙이 무엇을 들여오는지를 스스로 밝힌다. 한 분자가 안정한 형태를 둘 이상 가질 수 있는데도 하나만 안정으로 표시되므로, 이 라벨 방식은 어쩔 수 없이 잡음을 들여온다는 것이다.
모델은 3차원 구조를 만들지도, 양자역학 계산을 돌리지도 않는다. 원자와 결합으로 이루어진 2차원 그림만 보고 어느 형태가 안정한지를 맞히는 그래프 신경망이다. 그래프 신경망 세 가지와 분자 지문을 쓰는 기준선 하나를 나란히 시험한 끝에 AttentiveFP가 최종 모델로 뽑혔는데, 고른 기준이 눈에 띈다. 정밀도가 가장 높은 것이 아니라 검증셋 재현율이 가장 높은 쪽을 골랐다. 실제로 정밀도만 놓고 보면 AttentiveFP는 0.88로, 함께 시험한 다른 두 그래프 모델의 0.90보다 낮다.
이유는 논문에 적혀 있다. 진짜 안정한 형태를 놓치면 그것이 대개 단백질에 붙는 형태이므로 뒤따르는 도킹과 자유에너지 계산이 통째로 어긋나지만, 불안정한 후보가 몇 개 더 섞여 들어오는 것은 나중 점수 매기기 단계에서 걸러 낼 수 있다는 판단이다. 놓치는 쪽과 더 집어 오는 쪽 가운데 무엇이 더 비싼 실수인지를 먼저 정하고 모델을 고른 것이다.
이 연구가 한 일을 한 줄로 줄이면 정답지를 바꾼 것이 아니라 다른 정답지를 데려온 것이다. 단백질 구조에서 비어 있던 자리를, 소분자 결정이 실제로 본 수소로 채워 보자는 제안이다. 다만 새 정답지도 환경을 갖는다. 결정 속에서 본 수소이지 물속이나 단백질 주머니 안에서 본 수소가 아니다. 4절에서 이 단서가 숫자로 되돌아온다.
279건이 어긋났고 126건이 남았다
학습을 마친 모델을 PDBbind v2020에 걸었다. 결합력 예측 모델을 만들고 채점할 때 사실상 표준으로 쓰이는 자료다. 검사 대상은 처음부터 전체가 아니었다. 전하를 띤 작용기가 없는 리간드 6,202건으로 한 번 좁히고, 그중 토토머가 여럿 가능한 5,075건으로 다시 좁혔다. 널리 인용되는 2.5%의 분모가 이 5,075건이다. 좁히는 손질은 전하 말고도 더 있었다. 금속 이온이 리간드 바로 곁에 있는 복합체를 뺐고, 무거운 원자가 35개를 넘는 큰 리간드도 뺐다. 이온이 되는 분자는 수소가 붙고 떨어지는 문제와 토토머 문제가 엉겨 있어 따로 풀 수 없다는 것이 논문이 밝힌 이유다.
5,075건 중 279건에서 데이터베이스에 적힌 형태와 모델이 고른 형태가 달랐다. 여기서 연구진은 한 단계를 더 두었다. 모델이 다르다고 했다는 사실만으로는 어느 쪽이 맞는지 알 수 없으니, 구조 자체에 물어본 것이다. 수소 자리를 모델의 예측대로 바꿨을 때 단백질과 맺는 수소결합의 개수가 늘고 짝을 못 찾은 극성 원자의 개수가 동시에 줄어드는가. 두 조건을 함께 만족한 것이 126건이었다. 논문은 이 묶음을 구조로 판가름된 집합이라 부르고, 원래 지정이 틀렸을 가능성을 가장 강하게 받쳐 주는 사례로 본다.
이 126건에는 두 겹의 확인이 더 붙었다. 수소 자리를 바꾼 뒤 도킹 점수를 다시 매겨 실제 측정된 결합력과 대조해 보니 평균절대오차가 2.30에서 1.65kcal/mol로 내려갔다. 양자화학 계산으로 따져 보니 94%는 원래 형태보다 에너지가 유리했고, 98%는 그 차이가 물속에서 토토머 비율 1%에 해당하는 문턱인 2.76kcal/mol 안에 들어왔다. 표기 한 겹을 바꿨더니 채점표의 오차가 줄어든 것이다.
나머지 153건은 어떻게 됐나. 논문은 이쪽을 구조로 판가름되지 않은 집합이라 부른다. 예측과 지정이 어긋나기는 했는데 수소결합 증가와 극성 원자 감소가 함께 일어나지는 않은 경우다. 이들만 따로 도킹을 돌려 보니 원래 형태와 예측 형태 사이에 점수 차이가 유의미하게 나지 않았다. 판정을 내리지 않고 그대로 남겨 두었다는 뜻이다.
여기서 하나를 더 봐야 한다. 양자화학 계산은 이 153건에도 거의 같은 값을 준다. 예측 형태가 원래 형태보다 에너지상 유리한 비율이 95%, 차이가 2.76kcal/mol 안에 드는 비율이 97%다. 앞의 126건 쪽 94%와 98%에 견주면 사실상 구별되지 않는다. 두 묶음을 갈라놓은 것은 에너지가 아니라 단백질 주머니 안에서 수소결합이 늘고 짝 없는 극성 원자가 줄었느냐는 조건 하나다. 논문은 153건을 두고 수용체가 붙잡아 에너지가 높은 형태를 안정시켰을 가능성, 점수 함수 자체의 한계, 용매에 노출된 곳에서 일어난 변화라 결합에 미치는 영향이 옅을 가능성을 함께 꼽고, 결합 점수 함수가 상호작용만이 아니라 높은 에너지 형태를 취하는 데 드는 대가까지 셈에 넣어야 한다고 적는다.
무엇이 바뀌는지는 개별 사례에서 더 잘 보인다. 항암 후보로 개발된 CDK2 억제제가 들어 있는 2BPM 구조의 리간드 529는 두 가지 형태를 가질 수 있는데, 한쪽 형태에서는 LEU83·GLU81과 맺는 핵심 수소결합이 유지되지만 다른 쪽에서는 끊긴다. 모델은 결합이 유지되는 형태에 0.99, 끊기는 형태에 0.40을 매겼다. 연구진은 이 리간드에 대해 RCSB PDB에 실린 주석과 원 논문에 보고된 구조가 서로 어긋난다는 점도 함께 적었다. 또 다른 사례인 4BTX의 리간드 WF8은 가능한 형태를 전부 헤아리면 12가지나 되는데, 그중 결정학적 증거가 가리키는 형태에 0.96, ASP180과의 중요한 상호작용을 만들지 못하는 형태에 0.53이 매겨졌다.
2.5%는 작아 보인다. 다만 이 오류는 결합하느냐 마느냐를 틀리는 종류가 아니라 어떻게 결합하는지를 틀리는 종류다. 수소결합의 방향이 바뀌면 그 리간드를 정답으로 놓고 학습한 모델은 틀린 결합 방식을 정답으로 배운다. 그리고 분모를 기억해 둘 필요가 있다. 전하를 띤 리간드는 애초에 빠졌고 토토머가 하나뿐인 리간드도 빠졌다. PDBbind 전체에 대한 오류율이 아니다.
합친 점수와 갈라 본 점수
모델의 성능으로 가장 널리 인용되는 값은 재현율 0.97, 정밀도 0.88이다. 논문 초록에 적힌 값이기도 하다. 다만 이 값은 다섯 개의 평가셋을 하나로 합쳐 잰 것이고, 논문은 하나씩 잰 값도 따로 싣는다. 갈라 보면 숫자가 꽤 다르다.
가장 어려운 평가셋은 물속이다. 실험으로 측정된 토토머 비율을 가진 수용액 평가셋에서 정밀도는 0.72로 내려간다. 반대로 점수가 가장 후하게 나온 것은 여러 데이터베이스가 같은 형태로 적은 약물 유사 분자 평가셋으로, 재현율 1.00에 정밀도 0.91이다. 그런데 안정 토토머의 개수를 세어 보면 후한 두 평가셋이 762건과 2,177건이고 수용액 쪽은 142건이다. 다섯을 한 통에 부어 계산한 0.97과 0.88은 큰 쪽의 사정을 더 많이 반영한 값이다. 합친 점수가 틀렸다는 말이 아니라, 그 점수를 물속에서의 성능으로 읽으면 어긋난다는 말이다.
왜 물속에서 더 어려운지도 논문이 설명한다. 결정 안에서 어느 형태가 안정한지와 물에 녹았을 때 어느 형태가 우세한지는 같지 않다. 연구진이 오답을 유형별로 추려 보니 헤테로원자 사이의 수소 이동, 고리 안 질소끼리의 수소 이동, 케토-엔올 쌍에서 가장 많이 틀렸다. 대표 사례로 든 짝에서 실험 데이터베이스는 물속의 안정한 형태로 피리돈을 적었는데 모델은 엔올 쪽을 골랐다. 고체 상태에서 엔올을 선호하도록 배운 버릇이 물속 기준으로 채점되면서 오답이 된 것이다. 2절에서 남겨 둔 단서가 여기서 숫자로 돌아온다.
학습 라벨의 잡음도 측정됐다. 안정한 형태를 둘 이상 가진 분자만 따로 모아 모델이 그것들을 동시에 전부 맞히는지 보았더니 68.6%였다. 나눠 보면 검증셋은 71.0%, 수용액 평가셋은 59.5%다. 한 분자에 하나의 안정 형태만 적어 가르쳤는데도 여럿을 함께 짚어 내는 경우가 많다는 뜻이지만, 열에 서넛은 놓친다는 뜻이기도 하다.
견준 모델 가운데 가장 단순한 쪽의 성적도 표에 함께 실려 있다. 분자를 2,048비트짜리 지문으로 바꿔 평범한 다층 퍼셉트론에 넣은 기준선 모델이다. 합쳐 잰 재현율이 0.92, 정밀도가 0.84로 나왔다. 최종 모델로 뽑힌 그래프 신경망의 0.97과 0.88에 견주면 벌어진 폭이 넓지 않다. 논문도 이 대목을 그냥 지나가지 않고, 단순한 지문 기반 모델도 강한 성능을 보였다는 문장을 따로 적는다.
속도 수치에도 비슷한 사정이 있다. 460만 개 화합물을 GPU 한 장이 달린 노드에서 3.2시간에 처리했다는 문장이 보도마다 실렸는데, 논문의 표에는 네 개 라이브러리가 함께 있다. 그중 하나는 화합물 수가 더 적은데도 열 배 가까이 오래 걸렸다.
| 라이브러리 | 화합물 수 | 늘어놓은 토토머 수 | 걸린 시간 |
|---|---|---|---|
| Enamine | 4,671,131 | 24,102,643 | 3.19시간 |
| ChEMBL | 2,854,801 | 83,362,598 | 31.08시간 |
| ChemDiv | 1,614,271 | 8,238,810 | 0.97시간 |
| Asinex | 575,299 | 3,619,606 | 0.67시간 |
비용이 붙는 곳은 화합물 수가 아니라 거기서 나온 토토머 수다. Enamine은 분자 하나당 다섯 개 남짓이 나왔고 ChEMBL은 스물아홉 개가 나왔다. 화합물 수는 Enamine의 6할쯤인데 검사할 후보는 세 배 넘게 많았던 것이다. 3.2시간은 실제로 측정된 값이지만, 가장 수월했던 라이브러리에서 나온 값이다.
논문은 남은 한계도 밝힌다. 지금의 절차는 중성 유기분자에 주로 들어맞고 이온성 계, 금속 배위, 단백질이 붙잡아 안정화시키는 효과, 그리고 토토머 목록을 뽑는 프로그램 자체의 누락은 다루지 못한다. 수소가 붙고 떨어지는 문제와 토토머 문제를 함께 푸는 틀이 앞으로의 과제로 남아 있다는 문장으로 논의를 닫는다. 코드와 자료는 깃허브에 공개돼 있고, CSD 이용 약관 때문에 분자 구조는 싣지 못해 항목 번호만 제공한다.
페블러스가 이 논문을 주목하는 이유
지금부터는 이 논문을 데이터 품질의 눈으로 다시 읽는다.
126건은 모델을 더 잘 만들어서 찾아낸 것이 아니다. 기준 데이터를 다른 출처의 실험 자료와 맞대어 보고 나서야 드러난 것이다. 이 구분이 중요한 이유는 간단하다. 정답지에 결손이 있으면 그 정답지로 채점한 성능 수치에는 결손이 드러나지 않는다. 틀린 형태를 정답으로 놓고 학습한 모델은 그 형태를 잘 맞힐수록 높은 점수를 받는다. 점수가 올라도 무엇이 올랐는지는 알 수 없다.
그래서 물어야 할 것은 모델의 점수가 아니라 대조할 제2의 자료가 있느냐다. 이 분야는 운이 좋은 편이었다. 단백질 결정에서 안 보이던 수소가 소분자 결정에서는 보였고, 그것도 12만 개 넘는 분자에 쌓여 있었다. 대부분의 산업 데이터에는 그런 두 번째 실험이 없다. 라벨을 붙인 사람이 한 번 붙였고, 그것을 검산할 독립된 관측이 없다. 그 상태에서 정확도를 올리는 일은 정답지와 닮아 가는 일이지 참에 가까워지는 일이 아니다.
운이 좋았다고 해서 두 자료가 포개지는 것은 아니다. 연구진이 직접 세어 본 바로, 물속에서 안정한 것으로 확인된 토토머 625건 가운데 CSD의 중성 유기분자 집합과 겹치는 것은 129건, 20.6%다. 논문은 이 겹침을 결정에서 배운 지식이 물속으로 건너갈 수 있는 근거로 든다. 뒤집어 읽으면 나머지 여덟 할은 건너간 것이 아니라 건너갔다고 믿고 쓰는 부분이다. 대체 자료를 구했을 때 그것이 본래 자료를 얼마나 덮는지를 세어 두는 일, 그 수치가 있어야 뒤에 나온 성능이 어디까지 유효한지 말할 수 있다.
모델 기록도 같은 방향을 가리킨다. 분자를 2,048비트 지문으로 바꿔 평범한 다층 퍼셉트론에 넣은 기준선이 합산 재현율 0.92를 냈고, 공들인 그래프 신경망이 0.97을 냈다. 공들인 구조 설계가 벌어 준 차이가 여기서는 0.05다. 이 연구를 가능하게 한 것은 더 좋은 모델이 아니라 아무도 학습 자료로 쓸 생각을 하지 않던 결정학 수소 좌표였다. 성능을 끌어올릴 여지가 아키텍처에 남아 있는지 데이터에 남아 있는지를 먼저 재 보는 것, 우리가 모델 교체보다 데이터 진단을 앞에 두는 이유가 이것이다.
이 논문이 정직한 지점은 새 정답지에도 조건이 붙는다는 것을 스스로 적어 놓은 대목이다. 결정 속에서 본 수소는 결정이라는 환경에서 본 수소다. 물속 기준으로 채점하면 정밀도가 0.72로 내려가고, 가장 자주 틀리는 유형이 어디인지도 함께 밝혀진다. 정답표를 만든 규칙이 잡음을 들여온다는 문장도 논문 안에 있다. 대체 데이터를 가져오면서 그 데이터의 조건까지 같이 적어 두는 것, 우리가 데이터 진단에서 라벨 규칙과 작성 경위를 먼저 묻는 이유도 같다. 조건이 적혀 있으면 틀린 라벨은 고칠 수 있고, 적혀 있지 않으면 맞는 라벨조차 믿을 근거가 없다.
한 가지 더. 합친 점수 0.97과 갈라 본 점수 0.72는 같은 모델의 같은 시험에서 나온 값이다. 평가셋의 크기가 다르니 합치면 큰 쪽이 결과를 끌고 간다. 사내 평가표에서 여러 과제를 평균 낸 단일 지표를 쓰고 있다면, 그 평균이 어느 과제의 표본 크기에 기대고 있는지 한 번은 갈라 볼 만하다. 460만 건 3.2시간이라는 수치도 마찬가지다. 네 라이브러리 가운데 가장 수월한 쪽의 값이 대표값으로 돌아다닌다.
단백질과 약물의 데이터 품질은 페블러스가 전에도 짚은 자리다. 결합 부위 예측에서 정확도 지표와 실제 적중이 어긋나는 문제를 한 번 다뤘고, 단백질 구조는 풀렸지만 움직임에 관한 데이터가 비어 있다는 공백도 따로 살펴봤다. 이번 이야기는 그 둘과 층이 다르다. 없는 데이터도 아니고 모델이 틀린 것도 아니다. 있는 데이터 안에 사람이 채워 넣은 한 겹이 섞여 있고, 그 한 겹이 정답지 노릇을 해 왔다는 이야기다.
그러니 남는 질문은 이렇게 된다. 우리 모델이 받은 점수는 무엇과 비교해서 나온 점수인가. 그 비교 대상은 누가, 어떤 규칙으로, 무엇을 보고 만들었는가. 답이 "원래 그렇게 돼 있었다"라면 아직 아무도 그 기준을 검사해 본 적이 없다는 뜻이다.
여기까지 읽어 주셔서 감사하다. 이 글이 따라간 논문은 Chemical Science에서 전문을 무료로 볼 수 있고, 도구는 웹에서 바로 돌려 볼 수 있다. 여러분의 조직에서 모델을 채점하는 기준 데이터가 어떻게 만들어졌는지 적힌 문서를 찾을 수 있는지, 한 번 열어 보시고 이야기를 나눠 주시면 좋겠다.
참고문헌
학술
- 1.Pan, X.-L., Han, C., Han, F.-Y., & Zhang, Y.-K. (2026). "Deep learning of tautomer stability from crystallographic proton positions." Chemical Science. DOI: 10.1039/D6SC03714C.
공식 문서·도구
- 2.New York University. (2026). "Scientists Use AI to Find Stable Forms of Molecules for Drug Discovery." NYU News.
- 3.Pan, X.-L. (2026). "Tautomer-Predictor." GitHub — 논문의 데이터 준비·학습·예측 코드 공개 저장소(MIT 라이선스).
업계·보도
- 4.Phys.org. (2026). "AI scans 4.6 million compounds in hours to predict hydrogen positions in drug-like molecules."
- 5.Genetic Engineering & Biotechnology News. (2026). "Tautomer-Predictor AI Tool Identifies Stable Molecules for Drug Discovery."