Executive Summary
엔비디아가 로봇 기반모델 GR00T 2를 공개했다. 2026년 11월 9일 미국 오스틴에서 열린 로봇 학습 학회 CoRL 2026 현장에서다. 사전학습에 들어간 기록은 436,414시간인데, 그 가운데 로봇을 실제로 움직여 얻은 원격조작 기록은 23,500시간, 스무 시간에 한 시간 남짓이다. 나머지는 사람이 머리에 카메라를 달고 일하는 모습을 찍은 1인칭 영상과, 사람이 손으로 든 집게로 만든 시연이다.
사람 영상의 몫이 얼마나 되는지는 엔비디아 자신의 비교 실험에 나와 있다. 구조와 학습 방법을 고정한 채 사람 영상 비율만 0에서 100%로 바꾸자 72개 과제의 실물 로봇 진행률이 50%에서 70%로 올랐다. 사람의 기록이 그 성적을 떠받친다. 그런데 공개된 10만 시간짜리 데이터 카드에는 그 영상을 찍은 사람이 41,288명이라는 숫자만 있고, '동의'나 '프라이버시', '개인'이라는 낱말은 한 번도 나오지 않는다.
1절부터 4절까지는 엔비디아의 연구 페이지와 데이터 카드, 모델 카드에 적힌 사실이다. 5절에서 이 구성을 로봇을 들일 회사의 처지에서 보는 대목은 이 글의 해석이다.
주요 수치
네 칸을 뽑았다. 앞의 둘은 이 모델이 무엇으로 배워 무엇을 해내는지를, 뒤의 둘은 그 재료를 만든 사람의 규모와 그들에 관해 적히지 않은 것을 가리킨다.
출처: NVIDIA GEAR, "GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and Adaptation"(2026년 11월) 및 Human-1M-100K 데이터 카드.
5.4%
로봇이 직접 만든 기록
사전학습 436,414시간 가운데 원격조작은 23,500시간이다. 나머지는 사람의 몸에서 나왔다
95%
시연 다섯 번 뒤 성공률
다섯 번으로 배울 수 있는 과제 중에서 고른 50개의 평균이다. 그중 37개는 모든 시행에서 성공했다
41,288명
공개분을 찍은 사람
10만 시간 공개분의 촬영자 수다. 장면은 81,557개, 에피소드는 340만 개다
0회
데이터 카드의 '동의'
consent·privacy·personal 모두 본문에 등장하지 않는다. 납품 업체 식별자는 폴더 이름으로 남아 있다
로봇을 가르치는 데 로봇은 거의 쓰이지 않는다
GR00T 2는 엔비디아가 '세계-행동 모델(world-action model)'이라고 부르는 구조를 쓴다. 하나의 확산 트랜스포머가 앞으로 장면이 어떻게 변할지와 로봇이 어떤 동작을 해야 할지를 한 번에 추정한다. 장면이 어떻게 변할지를 맞히는 훈련은 영상만 있으면 되고, 그 영상에 로봇이 나올 필요는 없다. 이 설계가 학습 재료의 구성을 바꿔 놓았다.
엔비디아가 밝힌 사전학습 재료는 세 갈래다. 사람이 일하는 모습을 1인칭으로 찍은 영상 402,730시간, 사람이 손에 들고 쓰는 UMI 집게로 2,897개 과제를 시연한 기록 10,184시간, 그리고 로봇 원격조작 23,500시간이다. 원격조작 쪽에는 평행 집게가 달린 팔인 YAM과 프랑카, 손가락이 달린 샤파와 우지, 그리고 유니트리 G1 휴머노이드가 들어간다. 세 갈래를 더하면 436,414시간이고, 이 가운데 사람이 로봇을 움직여 만든 기록의 비율은 5.4%다.
비율만 놓고 보면 집게 시연과 원격조작을 합쳐도 7.7%다. 둘 다 사람이 몸을 써서 만든 기록이라는 점은 같지만, 로봇 관절에서 직접 나온 신호는 23,500시간뿐이다. 이 구성은 비용을 생각하면 자연스럽다. 로봇 한 대를 세워 두고 사람이 조종해야 쌓이는 기록과, 사람이 평소 하던 일을 찍기만 하면 되는 기록은 시간당 단가가 다르다.
학습 재료를 사람 쪽으로 옮기면 로봇 대수가 더는 병목이 아니게 된다. 대신 병목이 사람 쪽으로 옮겨 간다. 40만 시간을 찍으려면 사람이 40만 시간을 일해야 하고, 그 일하는 모습이 카메라에 담겨야 한다.
시연 다섯 번에 성공률 95%, 그렇게 배울 수 있는 과제 50개에서 나온 값이다
이렇게 배운 모델이 실제로 무엇을 하는지는 과제 50개로 측정됐다. 다른 로봇의 데이터나 사람 영상에는 나오지만 정작 평가에 쓰는 로봇의 학습 데이터에는 한 번도 나오지 않은 과제들이다. 로봇 데이터를 한 건도 주지 않고 돌리면 시행 기준 평균 성공률이 40%이고, 과제 기준으로는 50개 가운데 40개가 적어도 한 번은 성공한다. 과제마다 시연을 한 번씩 보여 주면 71%, 다섯 번씩 보여 주면 95%가 된다. 다섯 번에 해당하는 로봇 데이터는 3분이 채 되지 않지만, 그 뒤에 RTX 5090 한 장으로 30분쯤 걸리는 어댑터 미세조정이 한 번 붙는다. 이 조건에서 50개 중 37개는 모든 시행에서 성공했다. 접촉이 까다로운 끼워 넣기 과제 세 가지는 실물 로봇에서 강화학습을 한 바퀴 더 돌려 88~96%까지 올렸다.
이 숫자에는 엔비디아가 화이트페이퍼에 함께 적어 둔 조건이 하나 붙는다. 평가에 쓴 50개 과제는 시연 다섯 번으로 성공률 80% 이상에 이르는 과제들 가운데서 골랐다. 그러니까 95%가 덮는 범위는 '아무 새 과제나 스무 번 시키면 열아홉 번 해낸다'보다 좁다. '다섯 번 보여 주면 배울 수 있는 과제라면 거의 틀림없이 배운다'에 가깝다. 엔비디아가 이 선별 기준을 적어 둔 덕분에 숫자를 어디까지 밀어도 되는지가 같이 읽힌다.
속도 쪽도 공개됐다. 경량판인 GR00T 2 터보는 20억 파라미터짜리 영상·행동 결합 트랜스포머이고, 유니트리 G1에 실린 젯슨 토르에서 한 번 예측하는 데 124밀리초가 걸린다. RTX 5090에서는 38밀리초다. 엔비디아는 최적화로 중간 예측 지연을 66~86% 줄였다고 밝혔다. 기본판 GR00T 2의 파라미터 수는 연구 페이지에 적혀 있지 않다.
여기까지는 성능 보도가 주로 옮기는 숫자다. 데이터 쪽에서 더 눈여겨볼 것은 엔비디아가 함께 공개한 비교 실험이다. 구조와 학습법, 사후 원격조작 학습을 모두 고정한 채 사전학습에 넣는 사람 영상 비율만 없음·1%·10%·100%로 바꾼 모델 넷을 만들어, 덱스터 과제 72개에서 나란히 측정했다.
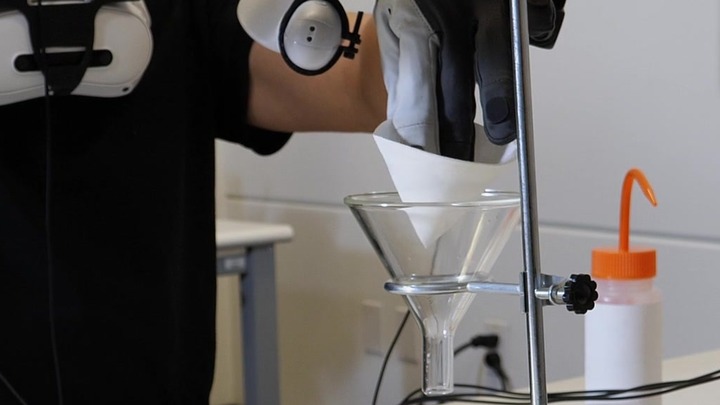
사람 시연
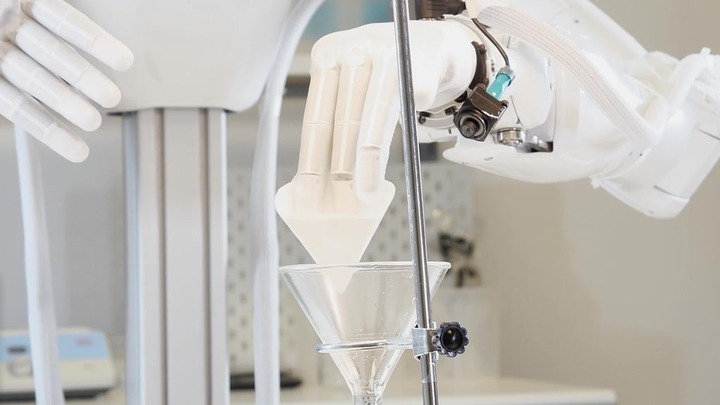
덱스터의 재현
사람 영상을 모두 넣은 모델은 영상 롤아웃에서 64%에서 77%로, 실물 로봇에서 50%에서 70%로 올랐다. 엔비디아는 가로축을 로그 눈금에 놓고 반복 시행의 표준편차를 막대로 함께 그렸는데, 이 그림이 전하려는 결론은 분명하다. 사람 영상에서 배운 것이 로봇의 몸으로 옮겨 간다는 것이다. 실물 로봇 쪽 20포인트가 모델의 성적표에서 사람 영상이 차지한 몫이라고 읽어도 과한 해석은 아니다.
이 실험이 중요한 까닭은 따로 있다. 데이터의 구성 비율이 92.3%라는 사실만으로는 그 데이터가 성적에 기여했는지 알 수 없다. 많이 넣었지만 쓸모가 적었을 수도 있다. 비교 실험은 그 가능성을 지운다. 엔비디아 스스로 사람 영상을 학습의 주재료로 지목한 셈이고, 그래서 그 재료가 어디서 왔는지가 이 모델을 가져다 쓸 회사의 질문이 된다.
그 영상은 업체가 주 단위로 납품한다
사람 영상 402,730시간의 출처는 엔비디아가 Human-1M이라고 이름 붙인 1백만 시간짜리 묶음이다. 그 가운데 10만 시간이 Human-1M-100K라는 이름으로 허깅페이스에 공개됐다. 라이선스는 CC BY 4.0이고 상업적 사용도 허용된다. 공개분만 놓고 봐도 에피소드 3,405,573개, 과제 묶음 406,815개, 장면 81,557개, 환경 범주 아홉 가지다. 영상은 최소 초당 30프레임에 480p 이상이고, 머리 카메라의 6자유도 자세와 양손 손가락 관절 21개가 함께 기록된다.
무엇을 찍었는지도 적혀 있다. 데이터 카드가 예로 든 과제를 그대로 옮기면 레이스 천 바느질, 오토바이 브레이크 수리, 만두피에 소 넣기, 치과 크라운 연마, 장난감 기어 조립, 배송 상자 포장과 봉함, 양배추 썰기, 토마토 수확, 유리병을 끈으로 묶기 같은 것들이다. 하나같이 누군가의 하루치 일이다. 촬영 환경을 가른 범주도 그 결을 따라간다. 산업 작업장, 현장 수리 작업장, 상업용 주방, 서비스 카운터와 돌봄, 스튜디오 작업대, 물류 현장, 농업, 가정이다. 데이터 카드는 범주가 아홉 가지라고 적어 놓고 이름은 여덟 개만 붙였다. 촬영 장소는 실제 가정과 작업장, 그리고 같은 작업을 반복할 수 있게 꾸민 스튜디오 둘 다다. 설명문도 두 겹으로 붙는다. 에피소드 전체의 목표를 한두 문장으로 적은 것과, 1초에서 10초 단위로 잘라 어느 손이 무슨 동사로 어떤 물건을 다뤘는지 적은 것이다.
데이터를 어떻게 모았는지는 데이터 카드의 다른 대목에서 드러난다. 공개 파일은 업체 → 묶음 → 판본 순으로 정리돼 있고, 디렉터리 이름 자체가 vendors/{vendor_id}다. 품질 감사 이력도 같은 얼개로 적혀 있다. 25주에 걸친 납품 기간 동안 받아들인 분량이 56만 1천 시간, 돌려보낸 제출 분량이 46만 1천 시간이다. 들어온 것의 절반 가까이가 기준에 못 미쳐 반려됐다는 뜻이다. 동시에 이 영상은 엔비디아가 직접 들고 찍은 기록이 아니라 바깥에서 주 단위로 들어온 납품물이다.
'수집자 41,288명'이라는 숫자는 그래서 읽는 법이 달라진다. 이들은 연구실에 모인 피험자가 아니라 여러 업체를 거쳐 들어온 촬영자들이다. 데이터 카드는 이들의 수를 세지만, 이들이 누구이고 어떤 조건에서 찍었는지는 세지 않는다.
데이터 카드 본문에서 '동의(consent)', '프라이버시(privacy)', '개인(personal)', '윤리(ethical)'라는 낱말을 찾으면 한 건도 나오지 않는다. 품질 관문은 꼼꼼하다. 설명문 정확도, 과제 품질, 다양성, 3차원 추적 검증을 사람 검토와 정량 검사로 함께 건다. 다만 그 관문이 보는 것은 영상이 학습에 쓸 만한지이지, 영상에 찍힌 사람이 그 쓰임을 알고 있었는지가 아니다.
엔비디아에는 이 질문에 답하는 서식이 이미 있다
엔비디아가 쓰는 모델 카드에는 '프라이버시 서브카드'라는 서식이 따로 있다. 개인정보가 쓰였는지, 동의를 받았는지, 삭제 요구를 받아 줄 수 있는지를 묻는 항목이 줄줄이 들어간다. 같은 회사의 1인칭 손 동작 모델 EgoHand-v1에는 그 서식이 실제로 채워져 공개돼 있다.
EgoHand-v1의 서브카드가 답한 내용은 이렇다. 학습에 개인정보가 쓰였고, 그에 대한 동의는 받았으며, 다만 그 데이터를 엔비디아가 직접 수집하지는 않았다. 데이터 주체에게 어떤 고지가 갔는지에 대해서는 '해당 없음'으로 적었다. 그리고 마지막 물음, 수정이나 삭제 요구를 받아 줄 수 있느냐에 이렇게 답했다.
| 프라이버시 서브카드 항목 | EgoHand-v1의 답 |
|---|---|
| 모델 제작에 개인정보가 쓰였는가 | 그렇다 |
| 쓰인 개인정보에 대해 동의를 받았는가 | 그렇다 |
| 데이터 주체의 열람·삭제 권리를 보장할 장치가 있는가 | 그렇다 |
| 그 개인정보를 엔비디아가 직접 수집했는가 | 아니다 |
| 데이터 주체에게 간 고지를 보관하거나 열람할 수 있는가 | 해당 없음 |
| 학습에 쓴 모든 데이터셋의 출처가 확인되는가 | 그렇다 |
| 수정·삭제 요구가 들어오면 반영할 수 있는가 | 아니다. 외부에서 조달한 데이터라 불가능하다 |
▲ 엔비디아 EgoHand-v1 모델 카드의 프라이버시 서브카드에서 일곱 줄을 옮겼다. 전체는 열세 줄이고, 마지막 줄은 회사 프라이버시 정책으로 가는 링크다.
같은 서식 안에서 두 줄이 서로 다른 답을 한다는 점이 이 표의 핵심이다. 다섯째 줄은 데이터 주체의 열람·삭제 권리를 보장할 장치가 있느냐는 물음에 '그렇다'고 답한다. 그런데 실제로 수정·삭제 요구가 들어왔을 때 반영할 수 있느냐는 마지막 물음에는 '아니다'라고 답하고, 그 이유로 외부에서 조달한 데이터라는 점을 든다. 장치는 마련돼 있지만 바깥에서 사 온 영상에는 그 장치가 닿지 않는다는 뜻이다. 권리가 어디서 끊기는지를 가른 것은 데이터의 성격이 아니라 조달 경로다. EgoHand-v1의 학습 데이터 설명도 같은 자리를 가리킨다. "머리에 쓴 1인칭 카메라로 촬영한 손 동작 영상을 외부 데이터 업체에서 사들였다"고 적혀 있다.
전작 GR00T N1-2B의 모델 카드도 비슷한 상태다. 데이터 수집 방식은 "혼합: 사람, 합성"이라는 한 줄로만 적혀 있고, 설명과 편향, 안전, 프라이버시 서브카드는 "더 자세한 내용은 별도 서브카드를 보라"는 문장으로만 가리킨다. GR00T 2의 가중치와 코드는 12월에 공개될 예정이라 모델 카드가 아직 없다. 지금 공개돼 있는 문서는 연구 페이지와 Human-1M-100K 데이터 카드인데, 데이터 카드 쪽에는 서브카드로 가는 링크도 없다.
서식이 없어서 비어 있는 자리가 아니다. 같은 회사가 같은 성격의 1인칭 데이터에 대해 이미 한 번 채워 본 서식이, 지금 가장 큰 1인칭 묶음 쪽에는 붙어 있지 않다. 12월에 모델 카드가 나올 때 이 칸이 어떻게 채워지는지가 확인할 지점이다.
페블러스가 GR00T 2를 주목하는 이유
피지컬 AI의 학습 재료가 사람 쪽으로 옮겨 가는 흐름은 한 회사의 선택이 아니다. 페블러스 블로그도 알리바바가 1인칭 영상 500시간으로 휴머노이드를 가르친 사례를 다뤘고, 로봇 학습 데이터를 층으로 줄 세워 어느 층이 비어 있는지도 살폈다. GR00T 2가 달라진 대목은 규모다. 500시간이 40만 시간이 되면 '누구를 찍었는가'는 연구 윤리의 각주가 아니라 공급망의 문제가 된다.
로봇을 들이려는 회사 입장에서 이 구조가 만드는 질문은 세 가지다. 첫째, 모델이 무엇을 보고 배웠는지 물을 통로가 있는가. 지금 GR00T 2에 대해 바깥에서 확인할 수 있는 것은 시간 수와 촬영자 수까지이고, 그 뒤는 납품 업체의 영역이라 보이지 않는다. 둘째, 그 영상에 찍힌 사람이 나중에 문제를 제기하면 그 모델을 쓰는 회사가 어디까지 책임지는가. EgoHand-v1의 서브카드는 외부에서 조달한 데이터라 수정·삭제 요구를 반영할 수 없다고 답했고, 그 답이 그 회사에 어떤 뜻인지는 적혀 있지 않다. 셋째, 우리 회사가 직접 사람을 찍어 데이터를 만들 때 무엇을 함께 적어야 하는가.
세 번째가 페블러스 독자에게 가장 가까운 질문이다. 공장이나 매장에서 직원의 작업을 1인칭으로 찍어 로봇 학습에 쓰려는 계획은 이미 여러 곳에서 검토되고 있다. Human-1M-100K의 데이터 카드는 그 계획에 좋은 본보기와 빈칸을 동시에 보여 준다. 에피소드마다 업체와 묶음, 판본, 장면 식별자, 촬영자 식별자를 남기고 납품 단위로 감사 이력을 붙이는 쪽은 그대로 가져올 만하다. 거기에 촬영자가 어떤 고지를 받았는지, 영상이 어디까지 쓰일 수 있는지, 보관 기한이 언제까지인지를 같은 명세서의 항목으로 세우는 일이 남는다.
데이터를 쓰지 말자는 이야기가 아니다. 1인칭 영상이 로봇의 성적을 20포인트 끌어올린다는 것은 엔비디아가 실험으로 보인 사실이고, 그만한 효용이 있으면 이 방향은 계속 간다. 다만 그 재료의 이력서가 시간 수에서 끊기면, 모델을 들이는 쪽은 자기가 무엇을 들였는지 모른 채 쓰게 된다. 데이터가 준비됐다는 말에는 품질뿐 아니라 출처도 들어가야 한다는 것이 페블러스가 AI-Ready Data를 말할 때의 뜻이다.
여기까지 읽어 주셔서 감사하다. GR00T 2의 발표 내용은 엔비디아 연구 페이지에서, 공개된 10만 시간은 Human-1M-100K 데이터 카드에서 직접 볼 수 있다. 여러분의 팀이 쓰는 모델 가운데, 무엇을 보고 배웠는지 끝까지 따라가 본 모델이 몇 개나 되는가?
참고문헌
엔비디아 연구 자료
- 1.NVIDIA GEAR. (2026). "GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and Adaptation." NVIDIA Research, 2026년 11월 9일.
- 2.NVIDIA GEAR. (2026). "GR00T 2 Whitepaper." NVIDIA.
데이터·모델 카드
- 3.NVIDIA. (2026). "PhysicalAI-Human-1M-100K." Hugging Face Datasets.
- 4.NVIDIA. (2026). "EgoHand-v1." Hugging Face Models.
- 5.NVIDIA. (2025). "GR00T-N1-2B." Hugging Face Models.
📚 피지컬 AI 데이터셋 허브
로봇이 배우는 데이터가 어떻게 모이고, 어떤 형식으로 쌓이고, 출처가 어디서 끊기는지를 다룬 글을 모았다. 피지컬 AI 데이터셋 허브에서 관련 글 더 보기