Executive Summary
이 글은 2026년 9월 30일 arXiv에 올라온 논문 한 편을 읽는다. 제임스웹 우주망원경이 찍은 외계행성 스펙트럼에서 대기의 온도와 성분을 읽어 내는 AI 추정기가 있다. 시뮬레이터가 만든 가짜 스펙트럼에서는 정확했는데, 제임스웹이 실제로 찍은 WASP-39b 앞에서는 답이 무너졌다. 저자들은 범인을 물리 모형이 아니라 추정기의 변수 목록에서 빠져 있던 행성 반지름 한 칸으로 지목했다.
반지름을 변수에 넣고 보정을 거치자 관측과의 어긋남을 나타내는 적합도가 301에서 0.06으로 내려갔다. 반지름이 없으면 행성이 별 앞을 지날 때 가리는 깊이의 약 3% 차이를 받아 줄 자리가 없고, 그 몫을 대기 조성과 온도가 대신 떠안는다는 것이 저자들의 설명이다. 다만 함께 오른 또 하나의 지표, 곧 일곱 변수의 구간이 기준값을 품은 비율에는 저자들이 직접 선을 그어 둔다. 그 기준은 자기들이 맞춰 놓은 것이라 독립적인 증거가 아니라고 논문 안에 적어 두었다.
1절부터 4절까지는 논문과 그 부록·체크리스트에 적힌 사실이다. 5절은 그 사실을 데이터를 다루는 사람의 눈으로 다시 읽은 이 글의 해석이다.
주요 수치
논문에 붙은 숫자는 네 개로 추릴 수 있다. 첫째는 관측과 모형 사이의 거리가 고치기 전후로 어떻게 달라졌는지이고, 둘째는 그 거리를 벌린 기준선 차이다. 셋째는 신경망을 빼고 따로 확인한 값이고, 마지막은 세 타겟 가운데 가장 낮게 나온 성적이다. 적합도 χ²/N은 관측과 모형이 얼마나 어긋나는지를 데이터 점 수로 나눈 값이고, 1 근처면 잘 맞는 것이다.
출처: Chakravertty & Raj, arXiv:2610.02245 (2026-09-30).
301 → 0.06
WASP-39b 적합도 χ²/N
반지름을 변수에 넣고 보정을 거친 뒤의 값
약 3%
흡수되지 못한 기준선 차이
반지름 칸이 없으면 이 몫을 대기 조성이 떠안는다
38.44 → 0.76
신경망 없이 확인한 적합도
물리를 더해도 38 근처였고, 반지름을 풀자 떨어졌다
6/7
K2-18b의 기준값 포함 칸 수
세 타겟 중 가장 낮다. 나머지 둘은 일곱 칸 전부
합성 스펙트럼에서는 맞던 추정기가 실제 관측에서 무너졌다
외계행성이 자기 별 앞을 지나갈 때 별빛의 일부가 행성 대기를 통과한다. 대기에 물이 있으면 물이 먹는 파장이 조금 더 어두워지고, 이산화탄소가 있으면 이산화탄소가 먹는 파장이 어두워진다. 파장별로 얼마나 어두워졌는지를 늘어놓은 것이 투과 스펙트럼이고, 제임스웹은 이것을 과거 어떤 망원경보다 선명하게 찍는다. 거기서 대기의 온도와 성분을 거꾸로 알아내는 일이 이 글이 말하는 대기 추정이고, 천문학에서는 영어로 retrieval이라 부른다.
전통적인 방법은 후보 대기를 수없이 만들어 보며 관측에 가장 가까운 것을 찾아가는 표본추출이다. 정확하지만 한 번 돌리는 데 오래 걸린다. 그래서 최근 몇 해 동안 다른 길이 열렸다. 복사전달 시뮬레이터로 가짜 스펙트럼을 수십만 장 만들어 신경망을 미리 학습시켜 두고, 실제 스펙트럼을 넣으면 곧바로 답을 받는 방식이다. 시뮬레이션 기반 추론(SBI)이라고 부른다. 이 논문의 추정기도 TauREx 3으로 학습 데이터를 만들고 흐름 기반 사후분포 추정기를 올린 구성이다.
문제는 이 방식의 신뢰가 시뮬레이터에 전적으로 매여 있다는 점이다. 논문 서론이 인용한 선행 연구의 경고가 그것이다. 시뮬레이터가 실제 기기와 어긋나 있으면 사후분포는 틀린 자리에 자신 있게 몰린다. 답을 못 내는 것이 아니라, 좁은 분포로 또렷하게 틀린 답을 낸다.
가짜와 진짜 사이가 벌어지기 쉬운 자리 두 곳은 저자들이 미리 막아 두었다. 하나는 파장 격자다. 학습용 스펙트럼을 나중에 평가할 실제 관측과 같은 파장 격자 위에서 계산해, 시뮬레이션과 실제 데이터 사이에 보간이나 재격자화 단계가 끼어들지 않게 했다. 다른 하나는 잡음이다. 깨끗한 잡음이나 서로 독립인 잡음만 보고 자란 신경망은 실제 제임스웹 스펙트럼 앞에서 무너지는데, 실제 기기가 남기는 잡음은 파장끼리 서로 상관을 갖기 때문이다. 그래서 학습 스펙트럼마다 상관 구조를 가진 잡음을 무작위로 섞어 넣었다. 로봇을 시뮬레이터에서 길러 현실로 내보낼 때 쓰는 영역 무작위화를 분광 자료로 옮겨 왔다. 붕괴는 이 두 자리를 닫아 놓고도 일어났다.
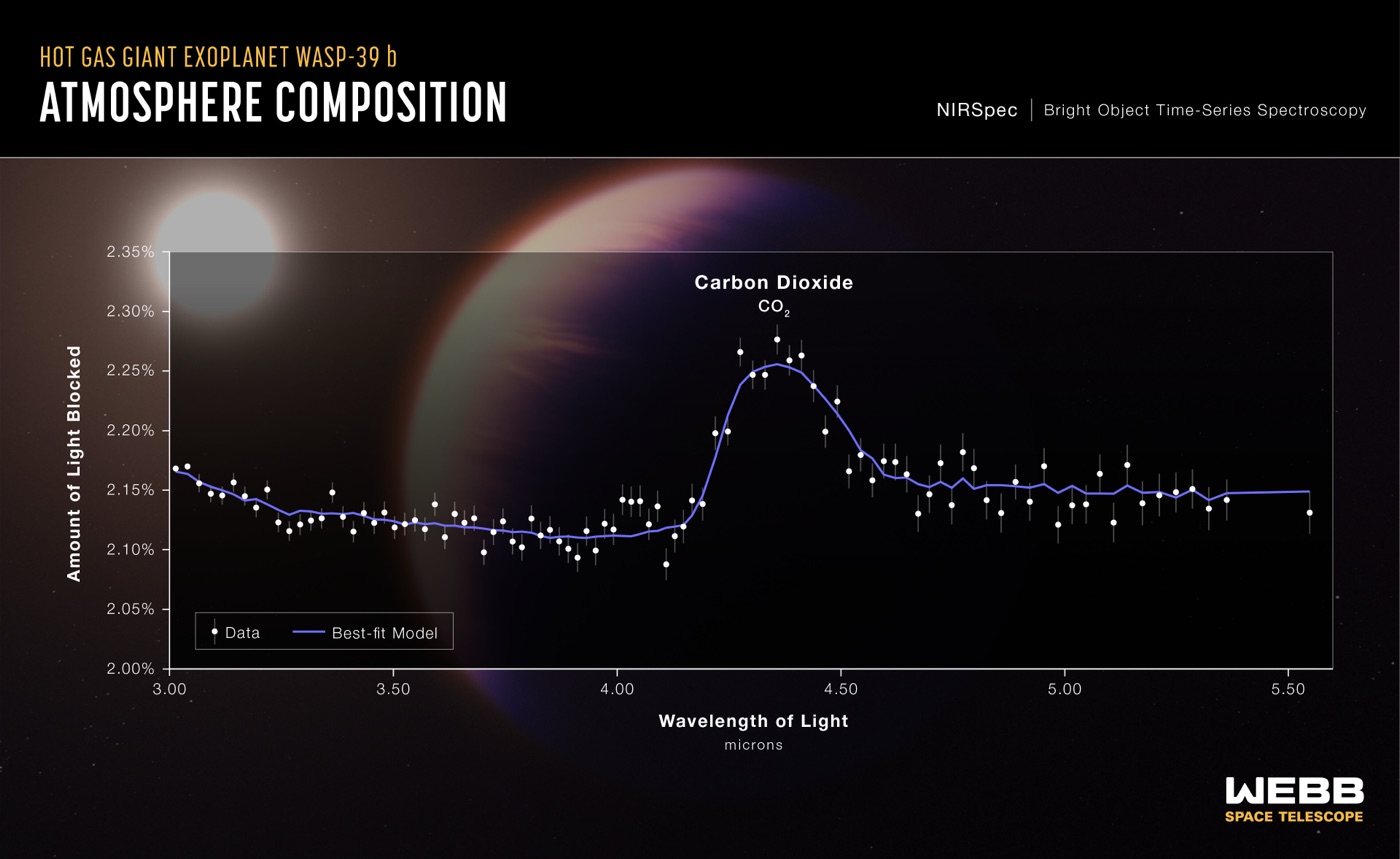
저자들이 실제 데이터를 넣은 첫 타겟이 WASP-39b다. 2023년에 발표된 제임스웹 NIRSpec PRISM 스펙트럼을 썼고, 52개 구간 가운데 실제로 덮인 47개를 적합도 계산에 넣었다. 추정기가 내놓은 답은 거의 차갑고 평평한 대기였다. 결과는 두 숫자로 요약됐다. 중요도 표집의 유효 표본 크기가 1까지 내려갔고, 최량적합 χ²/N이 301이 나왔다. 유효 표본 크기 1은 수천 개를 뽑아도 쓸 만한 표본이 사실상 하나라는 뜻이고, χ²/N 301은 관측과 모형이 수백 배 어긋나 있다는 뜻이다. 합성 스펙트럼에서는 멀쩡하던 추정기였다.
먼저 의심한 것은 물리 모형이었다
이런 일이 벌어지면 이 분야는 먼저 순방향 모형의 충실도를 의심한다. 분자를 하나 빠뜨렸거나, 불투명도 표가 낡았거나, 대기를 한 덩어리 온도로 뭉갠 가정이 거칠었거나. WASP-39b는 특히 그런 의심이 붙기 쉬운 타겟이었다. 제임스웹 관측 이후 이 행성의 스펙트럼은 모형을 괴롭히는 사례로 이미 여러 번 보고됐다.
다만 저자들이 쥔 단서는 반대쪽을 가리켰다. 이미 발표된 대기 추정 결과를 보면 같은 계열의 순방향 모형이 WASP-39b에 들어맞았다. 물리가 모자란 것이 아니라 자기들 설정의 어딘가가 남들과 다르다는 뜻이었다.
저자들의 검증 설계에서 눈여겨볼 대목은 순서다. 후보 물리를 하나씩 순방향 모형에 더한 다음, 그것을 신경망이 아니라 중첩 표본추출로 다시 적합시켰다. 논문의 문장을 옮기면 이렇다. "따라서 이 시험은 분할상각된 신경망과 무관하다." 신경망이 범인일 가능성을 아예 셈에서 빼 놓고 물리만 따로 재 본 것이다.
후보는 셋이었다. 등온 가정을 깨는 온도 기울기, 이산화황 불투명도, 그리고 더 정밀한 불투명도 표다. 논문 표 1은 그중 앞의 둘을 등온 기준선과 나란히 적어 두었다.
| 순방향 모형 변형 (표시 없으면 반지름 고정) | 최량적합 온도 (K) | χ²/N |
|---|---|---|
| 물리 대기, 등온 가정 | 700 | 38.44 |
| + 온도 기울기 | 700 | 38.48 |
| + 이산화황 불투명도 | 700 | 38.46 |
| 행성 반지름을 변수로 품 | 606 | 0.76 |
▲ 논문 표 1을 옮긴 것. 물리를 더한 두 변형은 소수점 둘째 자리만 움직였다 | 출처: arXiv:2610.02245
물리를 더해도 적합도는 38 근처에서 꼼짝하지 않았다. 표에 오른 두 변형은 오히려 등온 기준선보다 아주 미세하게 나빠졌다. 세 변형 모두에서 추정은 물리적으로 말이 되지 않는 차갑고 평평한 구석에 그대로 머물렀다. 그런데 반지름을 고정에서 풀어 준 마지막 줄에서 38.44가 0.76으로 떨어졌고, 추정 온도는 700K에서 606K로 내려왔다. 논문은 이 상태를 따뜻하고 물이 풍부한, 기존 문헌과 일치하는 대기로 돌아왔다고 적는다. 물리를 보태는 일과 변수를 하나 푸는 일 사이에서 결과를 가른 것은 후자였다.
반지름 칸이 비면 그 몫을 대기가 뒤집어쓴다
처음 추정기가 알아맞히려던 것은 여섯 가지였다. 대기의 온도 하나와 분자 다섯 종의 로그 풍도. 행성 반지름은 그 목록에 없었다. 학습 데이터를 만든 시뮬레이터 쪽에서는 반지름이 입력으로 멀쩡히 쓰이고 있었는데, 그 값을 거꾸로 알아맞혀야 하는 쪽의 목록에만 칸이 비어 있었다.
이 비대칭이 왜 치명적인지는 스펙트럼의 생김새를 보면 알 수 있다. 투과 스펙트럼의 세로축은 별이 얼마나 가려졌는지를 나타내는 깊이다. 그 깊이는 두 부분으로 나뉜다. 행성 덩어리 자체가 가리는 기준선과, 그 위에 대기가 파장별로 더 얹는 굴곡이다. 기준선의 높이를 정하는 것이 행성 반지름이다. 반지름이 변수로 없으면 기준선은 고정된 채이고, 실제 관측의 기준선이 그 고정값에서 약 3% 벗어나 있어도 모형은 그 차이를 받아 줄 자리가 없다. 남는 길은 하나뿐이다. 자기가 움직일 수 있는 칸, 곧 대기 조성과 온도를 비틀어 그 3%를 메우는 것이다.
▲ 페블러스 원본 도식 | 출처: arXiv:2610.02245 서론 및 3절
그래서 겉으로 드러나는 증상이 모형 오류와 똑같이 생겼다. 관측과 모형이 안 맞으니 물리가 모자란 것처럼 보인다. 그러나 실제로 벌어진 일은 식별 가능성의 붕괴다. 서로 다른 반지름과 서로 다른 대기 조성이 거의 같은 스펙트럼을 만들어 내는데, 반지름 칸이 닫혀 있으니 추정기는 그 모호함을 조성 쪽에서만 풀 수밖에 없었다. 논문의 결론 문장이 이 구분을 짧게 적는다.
시뮬레이터는 담고 있으나 추론이 생략한 요인 하나가, 제대로 세워진 순방향 모형마저 잘못 세워진 것처럼 보이게 만들 수 있다. 따라서 고쳐야 할 것은 충실도가 아니라 식별 가능성이다.
고친 방법은 이름만큼 거창하지 않다. 저자들이 MIRAGE라 부른 이 구성은 변수를 여섯에서 일곱으로 늘려 반지름을 포함시키고, 관측 환경을 무작위로 흔든 스펙트럼으로 학습시킨 다음, 퍼져 있는 흐름 사후분포를 독립적인 중첩 표본추출 기준에 최적수송 맵과 중요도 표집으로 끌어다 맞춘다. 논문도 스스로 정리한다. 새 구조가 아니라 변수 하나와 보정이 전부라고.
규모를 키워서 얻은 결과가 아니라는 점은 부록이 분명히 한다. 학습에 쓴 쌍은 2만 8천 개이고, 검증용으로 4천 개를 따로 뒀다. 신경망은 파라미터 100만 개 안팎의 작은 모형이고, 학습은 GPU 클러스터가 아니라 애플 실리콘 기계 한 대에서 끝났다. 공분산을 다루는 갈래만 연산이 불안정해 CPU로 돌렸다. 그 조건에서 손댄 곳은 알아맞힐 변수의 수 하나였다.
숫자는 돌아섰고, 한계는 저자들이 먼저 적는다
WASP-39b에서 최량적합 χ²/N은 301에서 0.06으로 내려갔고, 일곱 변수 가운데 보정된 구간이 기준값을 품은 칸은 둘에서 일곱으로 늘었다. 같은 방법을 손대지 않고 다른 두 타겟에도 적용했다. 논문이 내세운 범위는 세 방향으로 벌어진다. 행성 종류는 뜨거운 토성급에서 차가운 준해왕성급까지, 기기는 NIRSpec PRISM과 NIRISS SOSS, 스펙트럼의 출처는 남이 발표한 것과 저자들이 MAST 원자료부터 직접 재처리한 것이다.
그 범위를 받치는 증거는 아래 표의 세 번째 열에 있다. 보정을 거친 사후분포가 복원한 행성 반지름이 앞에, 기존 발표값이 괄호 안에 들어가는데, 세 타겟 모두 두 값의 차이가 작다. 직접 재처리한 WASP-96b에서는 1.4마이크로미터 자리의 물 특징도 되살아났다. 저자들이 출처의 다양성을 범위의 한 축으로 내세우는 근거가 그것이다.
| 행성 | 기기 | 복원한 반지름 (발표값), 목성 반지름 단위 | 기준값 포함 칸 |
|---|---|---|---|
| WASP-39b | NIRSpec PRISM | 1.227 (1.28) | 7/7 |
| WASP-96b | NIRISS SOSS | 1.196 (1.20) | 7/7 |
| K2-18b | NIRISS SOSS | 0.232 (0.24) | 6/7 |
▲ 논문 표 2를 옮긴 것. 포함 칸은 중첩 표본추출 기준값이 보정된 구간 안에 들어온 변수의 수다 | 출처: arXiv:2610.02245
여기까지는 깔끔하다. 그런데 논문은 자기 성과에 직접 선을 긋는다. 5절이 적은 한계가 셋이고, 끝에 붙은 체크리스트가 인정한 것이 둘이다. 다섯 모두 과장을 덜어 내는 쪽이다.
4.1포함 칸 수는 독립적인 증거가 아니다
보정은 타겟마다 중첩 표본추출을 한 번씩 돌려 기준을 만든 다음, 흐름 사후분포를 그 기준 위로 옮기는 식으로 작동한다. 그런데 포함 칸을 세는 기준도 같은 기준값이다. 맵이 기준에 맞도록 적합되었기 때문에, 같은 기준으로 평가한 포함 비율은 실제 스펙트럼에 대한 독립적 증거가 아니라 구성에서 따라 나오는 값이라고 저자들은 적는다. 그것은 전송이 풀렸음을 보여 줄 뿐, 신경망이 참 사후분포를 복원했음을 보여 주지는 않는다. 독립적인 부분으로 저자들이 남겨 둔 것은 복원된 반지름이 발표값과 가깝다는 사실뿐이다. 앞 표에서 1.227 대 1.28, 1.196 대 1.20, 0.232 대 0.24로 적힌 그 열이다.
보정한 뒤의 유효 표본 크기를 논문이 적지 않는 이유도 여기에 닿아 있다. 실제 관측처럼 가능도가 한 점에 뾰족하게 서면 그 값은 낮게 남는다. 그래서 보정이 잘 됐는지는 유효 표본 크기가 아니라 포함 비율로 보고한다고 2.3절이 밝힌다. 1절에 나온 1은 보정 전의 진단 수치이고, 그에 짝을 이루는 보정 후 수치는 논문에 없다.
분할상각의 이점도 그만큼 깎인다. 논문이 그대로 전이된다고 말하는 대상은 방법이지 학습된 가중치가 아니다. 부록의 사전분포를 보면 뜨거운 토성급 둘은 반지름을 목성 반지름의 0.8에서 1.6 사이에서 찾고, 차가운 준해왕성급 K2-18b는 0.10에서 0.40 사이에서 찾는다. 온도 범위도 같은 식으로 갈린다. 학습 표본을 사전분포에서 뽑는 이상 두 영역의 학습 집합이 같을 수는 없다. 거기에 더해 타겟이 바뀔 때마다 중첩 표본추출을 한 번은 치러야 한다. 논문의 표현으로는 타겟당 한 번의 중첩 표본추출을 여전히 지불한다. 느린 방법을 대체하려고 만든 빠른 방법이 느린 방법을 기준점으로 달고 다니는 셈이다.
4.2합성에서 통한 잡음 보정은 실제로 넘어오지 않았다
관측 잡음의 공분산을 조건으로 넣는 기법은 합성 벤치마크에서 포함 비율을 0.587에서 0.687로 올렸고, 잡음을 키울수록 이득도 커졌다. 그런데 실제 타겟 한 곳에서는 그 이득이 나타나지 않았다. 실제 기기 잡음이 학습에 쓴 잡음 모형의 분포 밖에 있기 때문이라고 논문은 적는다. 그리고 이것을 설명해 치울 결함이 아니라 정직한 경계로 보고한다고 덧붙인다. 입력 쪽에서 생성 모형으로 영역 차이를 메우려 한 시도를 논문은 세 번째 한계로 적는다. 그것도 구조적 무작위화보다 나을 것이 없었다. 그 시도의 정체는 CycleGAN으로 합성 스펙트럼을 실제 쪽 분포에 맞춰 번역하는 것이었다. 실제 쪽 표본은 WASP-39b 스펙트럼 한 장을 잡음으로 조금씩 흔들어 500장으로 불려 썼다. 저자들은 이 결과를 깨끗한 음성이라 부르고, 학습은 구조적 무작위화로 계속 가기로 했다.
4.3오차 막대가 없고, 코드는 아직 공개 전이다
논문에 붙은 체크리스트가 두 가지를 인정한다. 본문이 χ²/N과 포함 칸 수 같은 점 추정값을 보고할 뿐 오차 막대나 신뢰구간, 반복 실행의 변동, 통계적 유의성 절차를 제시하지 않는다는 것이 하나다. 재현 가능한 산출물을 공개하겠다고 적었으나 본문에 코드나 데이터 주소, 구체적인 재현 절차가 없다는 것이 다른 하나다. 저자들은 게재가 확정되면 공개하겠다고 밝혔다. 본문 6쪽에 그림 둘, 표 둘인 짧은 보고서라는 점을 감안해 읽을 대목이다.
페블러스가 이 논문을 주목하는 이유
외계행성은 멀지만 구조는 낯설지 않다. 데이터를 만드는 쪽과 그 데이터를 받아 쓰는 쪽이 같은 필드 목록을 들고 있는지, 우리는 평소에 그것을 확인하지 않는다. 대개 두 목록은 한 사람의 머릿속에서 같은 것이었다가, 코드와 테이블로 내려오면서 조용히 갈라진다. 이 논문에서 갈라진 폭은 정확히 한 칸이었다.
이 결함이 특히 늦게 발견되는 이유는 합성 평가가 그것을 못 보기 때문이다. 시뮬레이터가 만든 홀드아웃 데이터에서는 생성 쪽과 소비 쪽이 같은 설정을 공유하므로 기준선이 어긋날 일이 없고, 추정기는 좋은 점수를 받는다. 목록의 구멍은 바깥 데이터가 들어오는 순간에만 드러난다. 그것도 "모르겠다"는 얼굴로 오지 않는다. 좁고 확신에 찬 틀린 답으로 나타난다. 불확실성을 내는 모형이 불확실성까지 틀리게 내는 자리가 여기다.
진단 순서도 가져갈 만하다. 저자들은 성능이 나빠졌을 때 모형을 키우는 쪽으로 바로 가지 않았다. 후보 물리를 더해 보되, 그 결과를 신경망과 무관한 독립 추정기로 다시 확인했다. 그 한 걸음 덕분에 "물리가 모자란다"와 "변수 목록이 모자란다"가 갈렸다. 학습된 구성 요소를 셈에서 빼고도 같은 증상이 남는지 보는 일은 어떤 파이프라인에서도 비용이 적은 절차다. 같은 태도가 설계 쪽에도 있었다. 학습 스펙트럼을 실제 관측과 같은 파장 격자 위에 올려 두었기 때문에, 나중에 생긴 어긋남을 격자 탓으로 돌릴 길이 처음부터 막혀 있었다. 의심할 목록을 미리 줄여 놓는 일은 사고가 난 다음의 진단보다 싸다.
페블러스가 AI-Ready Data를 말할 때 되풀이하는 전제가 데이터의 생성 맥락이 기록되어야 한다는 것이다. 이 논문은 그 전제를 조금 다른 각도에서 받는다. 기록이 있어도, 받는 쪽이 그 칸을 읽지 않으면 없는 것과 같다. 시뮬레이터는 반지름을 알고 있었다. 추정기의 목록에만 없었을 뿐이다. 데이터 계약이 생성 쪽 스키마만 적고 소비 쪽 스키마를 적지 않는 한, 같은 종류의 빈칸은 계속 생긴다.
여기까지 읽어 주셔서 감사하다. 논문 본문과 표, 부록, 체크리스트는 arXiv 전문에서 직접 확인했다. 여러분의 파이프라인에서 학습 데이터를 만드는 쪽과 추정·서빙 쪽의 변수 목록을 마지막으로 맞춰 본 것이 언제인지, 그리고 그 어긋남이 어떤 지표에 어떤 얼굴로 나타났는지 나눠 주시면 좋겠다.
참고문헌
- 1.Chakravertty, A. & Raj, P V V. (2026). "A Missing Latent, Not a Missing Simulator: Radius-Augmented Inference for Real JWST Retrieval." arXiv:2610.02245.
- 2.Rustamkulov, Z., Sing, D. K., Mukherjee, S. et al. (2023). "Early Release Science of the exoplanet WASP-39b with JWST NIRSpec PRISM." Nature, 614, 659–663.
- 3.Madhusudhan, N., Sarkar, S., Constantinou, S., Holmberg, M., Piette, A. A. A. & Moses, J. I. (2023). "Carbon-bearing Molecules in a Possible Hycean Atmosphere." The Astrophysical Journal Letters, 956, L13.