Executive Summary
이 글은 스탠퍼드대학과 막스플랑크 지능시스템연구소, 인리아 연구진이 2026년 10월 8일 arXiv에 올린 BrickBench를 읽는다. 텍스트 한 줄을 주고 코딩 에이전트에게 실제 레고 부품으로 지을 수 있는 모형을 설계하게 시키는 시험이고, 과제 300개와 함께 BrickAgent라는 작업 환경을 공개했다.
가장 또렷한 결과는 그 환경을 뺐을 때 나왔다. BrickAgent를 쥔 GPT-6 Astra는 300개 과제 전부에서 조립 가능한 설계를 냈는데, 같은 모델에게 부품 라이브러리와 파일 형식 안내서만 건네자 유효 설계가 40%로 내려갔다. GPT-5.6 Luna는 300개 가운데 한 개만 남았다. 두 번 다 같은 모델이고 같은 과제였다. 빠진 것은 자기가 지은 것을 즉시 검사해 주는 도구 하나뿐이다.
1절부터 4절까지 옮긴 수치와 인용은 논문 본문과 부록 표, 그리고 프로젝트 사이트의 리더보드에서 가져왔다. 5절에서 데이터 파이프라인 쪽으로 옮기는 대목은 논문에 없는 이 글의 해석이다.
주요 수치
네 숫자를 뽑았다. 앞의 둘은 검사 환경을 뺐을 때 유효 설계가 어디까지 내려갔는지를, 뒤의 둘은 그때 구조가 어떻게 흩어졌는지와 사람 디자인까지 남은 거리를 가리킨다.
출처: Kulits 외 (2026), BrickBench: Evaluating Agentic Brick Design, arXiv:2610.12452.
1.00 → 0.40
GPT-6 Astra의 유효 설계 비율
BrickAgent를 치우자 300개 과제 중 40%만 조립 가능해졌다
300개 중 1개
GPT-5.6 Luna가 환경 없이 낸 유효 설계
환경이 있을 때는 같은 모델이 300개 전부를 통과했다
4.6 → 83.0
설계 하나가 나뉜 덩어리 수
Luna 기준 평균. 장면 하나가 네댓 덩어리이던 것이 여든 조각으로 흩어졌다
323 / 360
사람 디자인을 집어낸 횟수
평가자 다섯 명이 사람 설계와 에이전트 설계를 짝지어 비교했다
BrickBench가 채점하는 것
에이전트가 받는 주문은 한 줄이다. 프롬프트를 읽고, 실제 LDraw 부품 라이브러리에서 부품을 골라, 설명에 맞으면서 물리적으로도 지을 수 있는 레고 모형을 내놓으라는 것. 레고라서 가벼워 보이지만 부품 하나를 놓을 때마다 이웃 부품과 맞물리는 국소 제약과 전체 형태라는 전역 제약이 함께 걸린다.
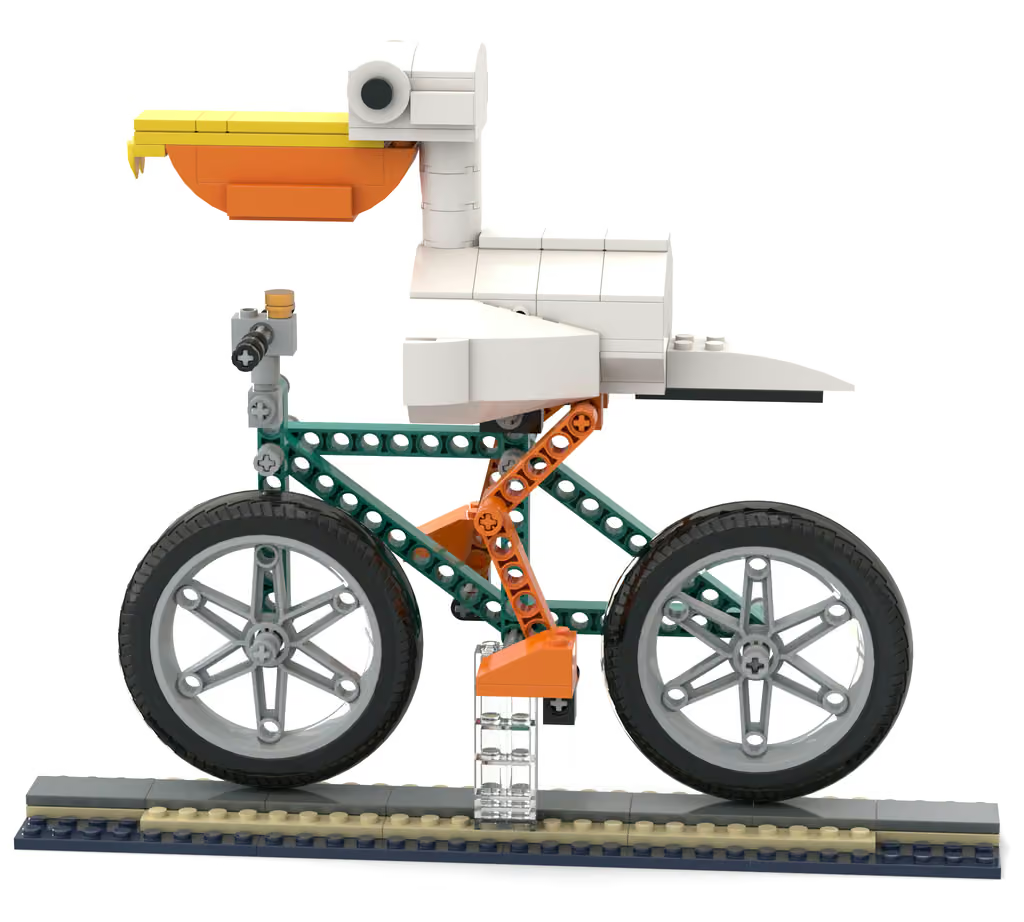
이런 일을 재는 시험이 없지는 않았다. 기존 평가는 부품 100개 이하의 작은 물건 하나를 놓고 설명과 얼마나 닮았는지를 봤다. 저자들은 거기에 두 가지가 빠져 있다고 적는다. 하나는 규모다. 리테일 세트는 부품이 수백에서 수천 개이고 쓸 수 있는 부품도 정해져 있다. 다른 하나는 디자인이다. 돌아가는 물건을 만드는 일과 만들 가치가 있는 물건을 만드는 일은 다른데, 디자인의 좋고 나쁨에는 통과와 탈락을 가를 시험이 없다. 같은 설명을 똑같이 충족하면서 완성도는 전혀 다른 두 모형이 얼마든지 나온다.
과제는 300개이고 세 설정으로 나뉜다. Model은 부품 400개 이하의 단일 구성물, Set은 400개에서 4,000개 사이의 리테일 세트급, Alt-Build는 리테일 세트 10698번에 든 783개 부품만 써서 다시 조립하는 과제다. 설정마다 100개씩이고, 중세와 성, 탈것, 기차, 우주, 예술품, 건축, 식물, 동물, 해적, 시대극이라는 열 가지 주제에 열 개씩 붙어 있다. 프롬프트 길이는 평균 45단어, 57단어, 31단어다.
채점은 네 축이다. Valid는 부품 요건을 채우고 충돌이 없고 중력 아래에서 안정한지를 본다. 안정성은 PyBullet 물리 시뮬레이션으로 확인하는데, 중력을 걸었을 때 구성 요소의 변위가 3 LDraw 단위 미만이어야 통과다. VQA는 프롬프트가 요구한 것들을 예·아니오 질문으로 쪼갠 뒤 Gemma 4 31B가 채점해 충족 비율을 낸다. ELO는 두 설계를 나란히 놓고 VLM이 고르게 한 결과를 브래들리·테리 모형으로 환산한 점수이고, 프롬프트와 얼마나 맞는지(Align ELO)와 프롬프트와 무관한 디자인 완성도(Design ELO)를 따로 매긴다. Cost는 설계 한 건에 들어간 토큰의 정가다.
이 글의 주인공은 함께 공개된 BrickAgent다. 에이전트는 부품을 검색하고, 커넥터를 기준으로 부품을 놓고, 돌리고 옮기고 뒤집고 치수를 확인하고, 부분 조립체를 정의해 합치고, 아무 시점에서나 렌더링해 볼 수 있다. 그리고 검사기가 붙어 있다. 연결이 끊겼는지, 어떤 부품끼리 충돌하는지, 어디서 무너지는지를 해당 부품을 짚어 돌려준다. 이것이 가능한 까닭은 LDraw 부품마다 타입이 붙은 커넥터가 미리 달려 있기 때문이다. 스터드와 힌지와 축과 볼과 고정, 다섯 종으로 나뉘어 있어서 좌표가 아니라 연결 관계로 조립을 다룰 수 있다.
에이전트는 프롬프트 하나에 300턴을 쓸 수 있다. 실행은 Codex CLI로 했고 Claude 계열은 Claude Code로 돌렸다. 환경 안내문은 도구 사용법을 예제와 함께 설명하고 설정별 부품 요건을 알려 준 다음, 숙련된 레고 디자이너가 공개된 세트의 기준으로 이 설계를 다른 설계와 견주어 볼 것이라는 말을 덧붙인다.
검사 도구를 쥐면 거의 다 짓는다
결과부터 적으면, BrickAgent를 쥔 에이전트는 물리적으로 틀린 설계를 거의 만들지 않는다. 시험한 열한 종 가운데 다섯이 300개 과제 전부에서 유효 판정을 받았다.
| 에이전트 | Valid | VQA | ELO | 설계 1건 비용 |
|---|---|---|---|---|
| GPT-6 Astra | 1.00 | 0.954 | 1297±22 | $4.06 |
| GPT-6.1 Sol | 1.00 | 0.945 | 1293±23 | $0.87 |
| Claude Opus 5.5 | 0.99 | 0.923 | 1249±23 | $6.33 |
| Claude Opus 5 | 1.00 | 0.908 | 1101±17 | $16.47 |
| Qwen 3.8 Flash | 0.90 | 0.852 | 1048±17 | $1.75 |
| GPT-5.6 Sol | 1.00 | 0.859 | 1015±16 | $1.02 |
| Gemini 3.8 Flash | 0.98 | 0.856 | 1014±17 | $3.70 |
| DeepSeek V4.1 Flash | 0.94 | 0.813 | 1006±17 | $0.71 |
| GPT-5.6 Luna | 1.00 | 0.792 | 898±16 | $0.75 |
| Muse Spark 1.3 | 0.80 | 0.718 | 868±20 | $6.68 |
| GLM 5.3 Flash | 0.92 | 0.590 | 752±23 | $0.54 |
세 설정 300개 과제를 합친 전체 집계. ELO는 Align ELO와 Design ELO를 합친 종합 점수다. 출처: arXiv:2610.12452 표 1.
표에서 눈이 멈추는 자리가 두 군데다. 하나는 맨 위 두 줄이다. GPT-6 Astra의 1297과 GPT-6.1 Sol의 1293은 오차 구간이 겹쳐 둘을 가를 수 없는데, 설계 한 건에 드는 비용은 4.06달러와 0.87달러로 네 배 넘게 벌어진다. Claude Opus 5는 16.47달러로 가장 비싸면서 종합 순위는 네 번째다. 성적과 비용이 나란히 가지 않는다.
남은 흠도 어디서 생겼는지 적혀 있다. 기준 집합인 아홉 에이전트가 낸 설계 가운데 유효 판정을 받지 못한 것이 137개였고, 그중 44개는 아예 결과물이 나오지 않은 경우다. 나머지는 중력 아래에서 무너졌거나(41개), 부품끼리 겹쳤거나(31개), 설정이 정한 부품 수를 지키지 않았다(21개). 세 설정 가운데 가장 많이 깨진 쪽은 400개에서 4,000개를 쓰라고 한 Set이다. 유효 비율이 Muse Spark 1.3에서 0.68, Qwen 3.8 Flash에서 0.79까지 내려갔고, 부품 수 분포를 보면 대부분의 에이전트가 400개 하한선 바로 위에 몰려 있다. 크게 지으라고 하면 설정이 허락하는 가장 작은 장면을 짓는다는 뜻이다. 예외는 Astra로, 두 설정 모두에서 다른 에이전트보다 부품을 훨씬 많이 쓴다.
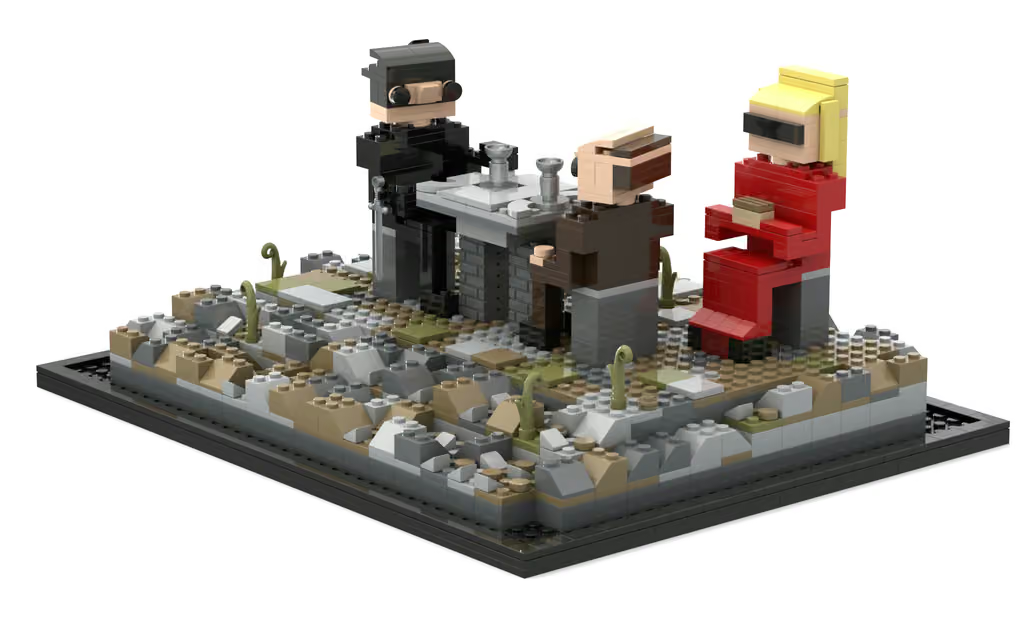
두 번째 자리는 Valid 열과 VQA 열이 따로 논다는 점이다. GPT-5.6 Luna는 300개 전부를 조립 가능하게 지었지만 VQA는 0.792로 아홉 번째이고, Claude Opus 5.5는 Valid 0.99로 전부를 채우지는 못했는데 VQA는 0.923으로 세 번째다. 조립 가능성은 검사기가 즉시 답을 주는 제약이라 상위권이 촘촘히 모인다. 반면 무엇을 지으라고 했는지를 얼마나 채웠는가는 0.590에서 0.954까지, 디자인 완성도는 Design ELO 753에서 1299까지 벌어진다. 검사기가 돌려주지 않는 축에서 모델이 갈린다.
도구를 치우면 같은 모델이 무너진다
저자들은 GPT-6 Astra와 GPT-5.6 Luna에게 같은 과제 300개를 한 번 더 시켰다. 이번에는 BrickAgent를 주지 않고 LDraw 부품 라이브러리와 파일 형식 안내서만 건넸다. 가중치도 과제도 그대로이고, 달라진 것은 만든 것을 그 자리에서 되짚어 볼 수단뿐이다.
GPT-6 Astra의 유효 설계는 1.00에서 0.40으로 내려갔다. GPT-5.6 Luna는 300개 가운데 한 개만 남았다. 환경이 있을 때 둘 다 1.00이었으니, 이 간극은 모델 사이의 차이가 아니라 한 모델 안에서 생긴 차이다.
무너지는 모양도 기록돼 있다. 충돌하는 부품 쌍은 Astra가 평균 0.00에서 7.19로 늘었고 Luna는 155.51까지 갔다. 설계 하나가 몇 덩어리로 나뉘는지를 세는 연결 요소 수는 Astra가 2.21에서 6.12로, Luna가 4.60에서 83.00으로 늘었다. 여러 물건이 놓인 장면이면 덩어리가 여럿인 것이 정상이고, 환경이 있을 때 평균이 둘에서 다섯 사이였던 까닭도 거기에 있다. 83은 그 범위 밖이다. 붙어 있어야 할 것들이 따로 떨어져 나온 결과다.
다만 무너진 것은 조립 가능성뿐이다. 환경을 빼도 Astra의 VQA는 0.954에서 0.940으로 0.01 남짓 내려가는 데 그쳤고 종합 ELO는 오차 구간 안에서 움직였다. Luna는 오히려 올라갔다. VQA가 0.792에서 0.813으로, 종합 ELO가 898에서 960으로 62점 올랐다. 검사기를 빼앗긴 Luna는 프롬프트를 더 잘 담아내고 보기에도 나은 모형을 냈다. 다만 그것을 실제로 지을 수 없었다. 저자들은 조립 가능성이라는 제약이 표현을 제한하는 것으로 읽었다. 뒤집으면 검사기는 자기가 검사하는 축만 끌어올린다. 1.00과 0.40으로 갈린 것은 그 축이고, 나머지 축은 검사기가 있든 없든 거의 그대로였다.
한 가지 오독을 미리 막아 둔다. Luna는 "두 번째로 잘하는 모델"이 아니다. 종합 ELO 898로 열한 종 가운데 아홉 번째다. 이 둘은 1등과 2등이 아니라, 환경을 뺐을 때 절반쯤 버티는 쪽과 그대로 주저앉는 쪽이다.
에이전트는 전용 모델을 이기고 사람에겐 진다
앞의 표에는 싣지 않았지만, 논문의 같은 표에는 비교 대상이 둘 더 있다. 레고 생성을 위해 따로 학습한 BrickNet-14B와 BrickGPT다. 둘 다 범용 코딩 에이전트에 크게 밀렸는데, 밀린 방향이 서로 반대라 읽을 거리가 있다.
BrickNet-14B는 Valid 0.26에 VQA 0.180이다. 이 0.26은 충돌이 없는 비율만 센 값이다. 모델이 설계를 정해진 기준 자세로 내놓지 않아 중력 방향을 정할 수 없어서 안정성 검사를 뺐다고 논문은 각주에 적었다. ELO를 둘로 가르면 Design ELO는 952로 범용 에이전트인 GLM 5.3 Flash(753)나 Muse Spark 1.3(878)보다 높은데, Align ELO는 485로 전체 최하위권이다. 레고답게 생긴 물건은 만들지만 시킨 물건은 아니라는 뜻이다. BrickGPT는 반대쪽 극단이다. Valid 1.00으로 300개 전부가 조립 가능한데 VQA는 0.024다. 논문은 "모든 프롬프트에서 유효하지만 질문의 2%를 충족한다"고 적었다. 조립 가능성 하나만으로는 설계를 평가할 수 없다는 사실이 이 두 숫자 사이에 있다.
이 대결에는 앞선 실험이 하나 더 있다. 저자들은 BrickBench를 만들기 전에 GPT-5.6 Luna를 BrickNet의 원래 검증 세트에 그대로 올려 봤다. 부품 100개 이하의 물건을 설명문 512개로 재는 기존 시험이다. 레고 데이터로 학습한 적 없는 범용 에이전트가 세 지표 모두에서 BrickNet과 BrickGPT를 앞섰고, 사람이 만든 정답 모형과의 차이가 지표마다 0.02 이내였다. 기존 시험이 사실상 포화됐다는 뜻이고, 저자들이 더 어려운 시험을 새로 만든 이유도 여기에 있다.
논문이 평가에서 얻은 발견 네 가지 가운데 첫째가 이것이다. 과제를 위해 만든 데이터 기반 모델이 범용 에이전트에 흡수된다는 것, 범용 에이전트가 그 모델들의 시험에서도 이기고 이번 시험에서도 이긴다는 것. 검사 도구가 조립 가능성을 떠받치고 있었다는 3절의 결론과 같은 방향이다. 다만 비용은 반대로 간다. BrickNet-14B는 설계 하나를 0.0006달러에 내놓고 Astra는 4.06달러를 쓴다. 전용 모델을 밀어낸 대가가 900배에서 6,800배의 비용이라고 논문은 적었다.
그런데 사람과 견주면 이야기가 달라진다. 레고에 익숙한 평가자 다섯 명에게 에이전트 설계와 사람이 만든 설계를 부품 수를 맞춰 짝지어 보여 주고 어느 쪽이 사람 것인지 고르게 했다. 360회 가운데 323회, 열에 아홉 꼴로 사람 것을 집어냈다. 에이전트별로 봐도 사람으로 오해받은 비율이 다섯 번에 한 번을 넘긴 곳이 없었다. 가장 자주 사람 것으로 꼽힌 GPT-6 Astra가 자기 몫 21쌍 가운데 4쌍이다. 다만 짝지은 사람 설계는 BrickNet 데이터셋에서 부품 수만 맞춰 뽑은 것이라 주제까지 같지는 않다. 주제를 맞추려면 설계를 따로 의뢰해야 해서 다음 과제로 남겼다고 저자들은 적었다.
디자인 점수 자체가 믿을 만한지도 따로 확인했다. Prolific에서 모은 102명이 한 사람당 40쌍씩 모두 4,080건을 판정한 결과 그 순위가 VLM의 Design ELO와 에이전트 36쌍 중 34쌍에서 일치했다(켄달 타우 0.89).
논문 서론에 이 대비를 적어 둔 문장이 있다. "Agents are learning to build what works, but not yet what makes a great design." 작동하는 것은 배우고 있지만 무엇이 좋은 디자인인지는 아직이라는 뜻이다. 저자들이 밝힌 한계도 같은 자리에 있다. 안정성 검사는 연결의 강도를 보지 않아서, 균형만 잡히면 실제로는 처지거나 떨어질 모형도 통과한다.
페블러스가 이 연구를 주목하는 이유
이 소식은 보통 'AI가 레고도 설계한다'는 이야기로 소비된다. 데이터를 다루는 쪽에서 보면 다른 자리가 먼저 보인다. 1.00과 0.40을 가른 것은 모델 파라미터가 아니다. 두 조건에서 가중치는 같았다. 달라진 것은 에이전트가 자기 결과물을 기계가 읽을 수 있는 형태로 되짚어 볼 수 있었는지다.
BrickAgent의 검사기가 돌려주는 것을 풀어 보면 세 가지 질문의 답이다. 이 부품이 저 부품에 붙어 있는가, 어떤 부품끼리 겹쳐 있는가, 중력을 걸면 어디서 무너지는가. 셋 다 사람이 눈으로 봐야 아는 판단이 아니라 데이터로 즉시 답이 나오는 질문이다. 그 답이 있으면 에이전트는 300턴 동안 고치고 다시 검사하기를 되풀이한다. 답이 없으면 GPT-5.6 Luna처럼 부품을 평균 156쌍 겹쳐 놓고도 다 지었다고 내놓는다.
우리 현장으로 옮기면 질문 하나가 남는다. 에이전트에게 일을 맡길 때, 그 일이 제대로 됐는지를 기계가 읽을 수 있는 형태로 알려 주고 있는가. 데이터 적재 작업이라면 스키마 위반과 중복 키와 참조 무결성이 그 자리에 해당하고, 라벨링이라면 라벨 사이의 모순과 경계 사례의 일관성이 그 자리다. 이런 검사가 파이프라인 바깥의 사후 리뷰에만 있으면 에이전트는 그것을 쓰지 못한다. 작업 도중에 호출할 수 있는 자리에 있어야 BrickAgent와 같은 역할을 한다.
물론 이 논문이 다룬 것은 레고다. 부품 연결과 충돌과 중력은 정답이 계산으로 정해지는 제약이고, 데이터 품질 문제의 상당 부분은 그렇지 않다. 무엇이 좋은 디자인인지를 에이전트가 아직 못 배운 것처럼, 무엇이 좋은 데이터인지도 검사기 하나로 정해지지 않는다. 그래도 계산으로 정해지는 몫만큼은 검사기로 돌려줄 수 있고, 이번 실험은 그 몫이 성적의 어디까지를 떠받치고 있었는지를 숫자로 적어 두었다.
여기까지 읽어 주셔서 감사하다. 논문 전문은 arXiv:2610.12452에서, 리더보드와 갤러리는 brickben.ch에서 볼 수 있다. 에이전트에게 작업을 맡기면서 그 결과를 기계가 검사하도록 만들어 둔 팀이 있다면, 무엇을 검사 항목으로 세웠는지 나눠 주시면 좋겠다.
참고문헌
R.1학술 논문
- 1.Kulits, P., Xu, Y., Jones, R. K., Schmid, C., & Wu, J. (2026). "BrickBench: Evaluating Agentic Brick Design." arXiv:2610.12452.
R.2공식 자료
- 2.BrickBench 프로젝트 사이트. "BrickBench — 벤치마크 설명과 리더보드."
- 3.Kulits, P. "BrickAgent." GitHub 저장소.