Executive Summary
아마존이 희귀본의 제본을 잘라 AI 학습용으로 스캔하는 시설을 운영하고 있다는 사실이 드러났다. 404 미디어가 희귀본 배송 상자에 위치추적장치를 넣고 신호가 멈춘 곳을 따라간 취재 결과다. 신호가 끝난 곳은 라스베이거스의 시설 VGT3였고, 이 시설이 상징으로 쓰는 그림은 책을 발톱으로 움켜쥔 공룡이다.
그 안에서 벌어지는 일은 스캔만이 아니다. 현장 직원들의 말로는 도착한 책의 제본을 잘라 낸 뒤 스캔하고, 그 과정에서 인쇄본은 남지 않는다. 스캔한 데이터는 아마존의 자체 모델 Nova 학습에 쓰인다. 인쇄본이 이렇게까지 값이 나가는 이유 하나는 출간 연도에 있다. 2022년 이전에 나온 책에는 LLM이 쓴 문장이 섞여 있을 수 없고, AI가 만든 텍스트로 다시 학습하면 모델 붕괴 위험이 커지기 때문이다.
이 소식이 데이터를 다루는 쪽에 남기는 질문은 아마존을 어떻게 평가할지가 아니다. 원본이 사라진 뒤 이 스캔본이 어느 판본에서 나왔는지 누가 무엇으로 확인하는가. 대조할 원본이 없는 상태에서 스캔 품질은 무엇으로 보증하는가. 이 글은 그 두 질문을 따라간다.
주요 수치
앞의 두 숫자는 인쇄본이 지금 왜 원료로 취급되는지를 가리키고, 뒤의 두 숫자는 그 원료를 모으는 일이 이미 법정과 시장을 한 바퀴 돌았다는 사실을 보여 준다.
출처: TechCrunch (2026-08-17), 404 Media (2026-07-31), 페블러스, 앤트로픽 저작권 합의 분석
2022년
원료 순도의 기준선
그 이전 출간물에는 LLM이 쓴 문장이 섞일 수 없음
0권
스캔 뒤 남는 대조용 원본
제본을 자른 인쇄본은 재검증에 다시 쓸 수 없음
15억 달러
앤트로픽 해적판 트랙 합의액
적법 구매 후 파괴적 스캔은 공정 이용으로 갈림
9일
ISBNdb가 중개 페이지를 내리기까지
보도 아흐레 뒤 서비스 홍보를 삭제하고 부인
추적기를 넣은 책이 멈춘 곳
보도의 출발점은 서적상들 사이의 소문이었다. 누군가 희귀본을 수집가의 방식과는 다르게, 목록을 훑듯이 대량으로 사들이고 있다는 이야기였다. 404 미디어는 사는 쪽을 캐묻는 대신 팔려 나가는 물건을 따라가기로 했다. AI 기업이 사들일 것으로 의심한 희귀본 배송 안에 위치추적장치를 넣고, 그 화물이 미국을 가로질러 마지막에 어디에서 멈추는지 지켜봤다.
멈춘 곳은 라스베이거스의 아마존 시설이었다. 404 미디어는 이 시설을 VGT3라고 부르며, 아마존이 AI 학습 데이터를 위해 책을 스캔하는 곳이라고 적었다. TechCrunch는 이 시설이 책을 발톱으로 움켜쥔 공룡 그림으로 자기를 표시한다고 전했다. 아마존이 대량의 책을 사들여 AI 학습용으로 스캔하고 그 과정에서 책을 없애는 이 작업은 그때까지 보도된 적이 없었다.
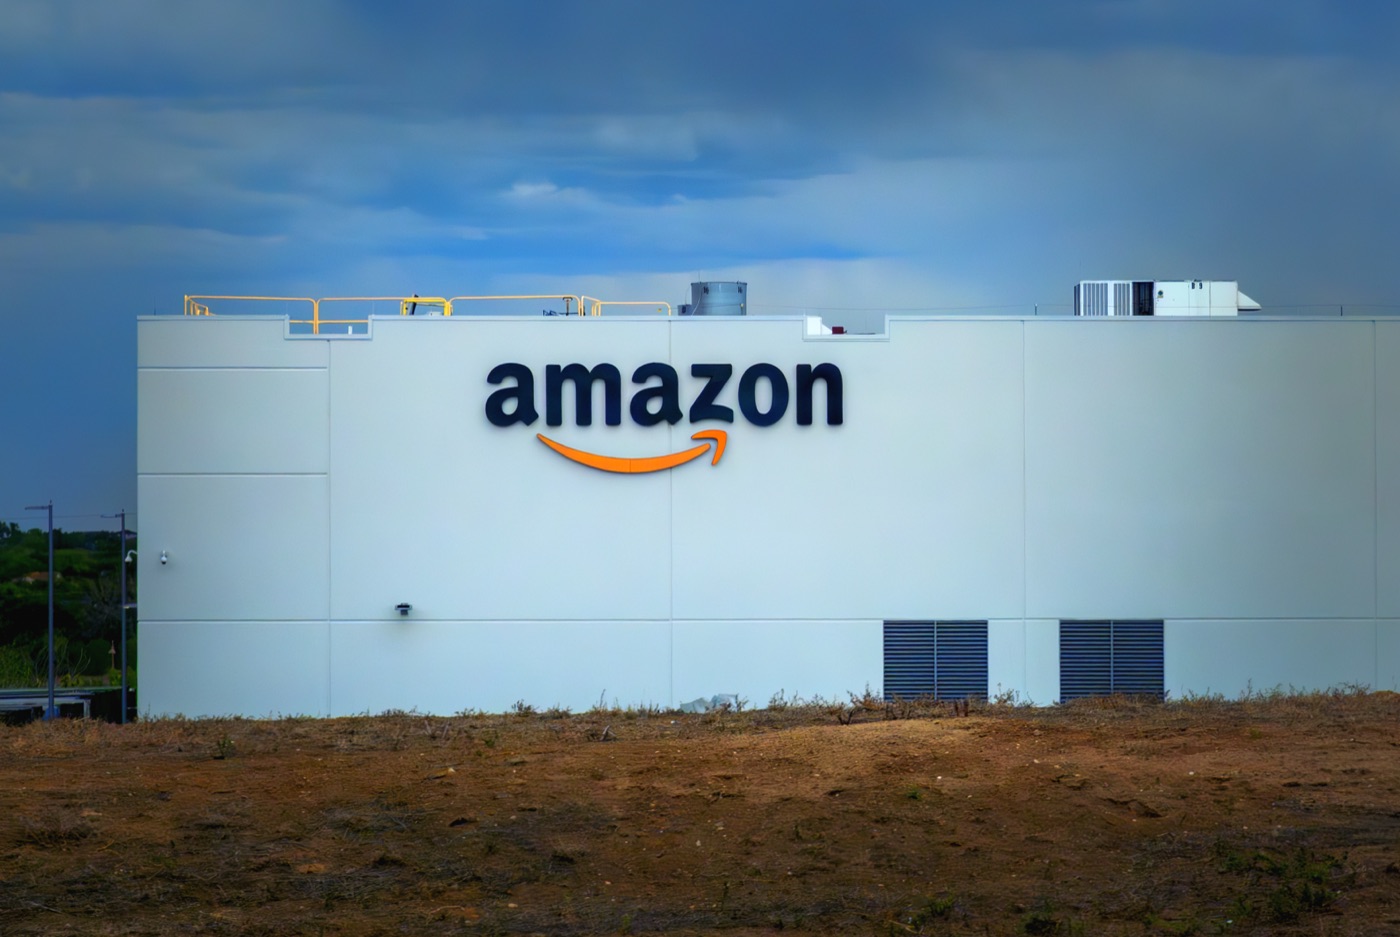
추적장치 하나가 증명한 것은 딱 한 가지다. 책이 어디로 갔는지다. 그런데 그 한 가지가 나머지 논의의 성격을 바꾼다. 학습 데이터의 출처를 두고 지금까지 오간 이야기는 대부분 웹 크롤링과 라이선스 계약, 그리고 섀도 라이브러리 같은 온라인 경로였다. 이번에는 트럭과 창고, 재단기가 등장한다. 데이터 취득이 물리적 공정이 되면 되돌릴 수 없는 단계가 생긴다.
제본을 자르면 스캔이 빨라진다
시설에서 일한 사람들의 설명은 단순하다. 대량으로 도착한 책의 제본을 잘라 내면 낱장으로 넘길 수 있어 스캔 속도가 올라가고, 그렇게 처리된 인쇄본은 원래 형태로 돌아가지 못한다. 아마존은 이 데이터를 자체 모델 Nova 학습에 쓴다. 회사가 404 미디어에 낸 입장은 상업적 경로로 책을 구매해 고객이 쓰는 제품과 서비스를 개선한다는 것이었다. 구매가 적법한지를 말한 문장이고, 구매한 책이 그 뒤 어떻게 되는지에 대한 답은 아니다.
속도를 올리는 선택이 왜 파괴로 이어지는지는 규모를 함께 보면 드러난다. 서적상들은 AI 기업들이 ISBN 번호를 기준으로 사실상 모든 책을 차례로 스캔하려는 것이 아닌지 의심하고 있다. 목록을 채우는 일이 목표가 되면 한 권을 얼마나 조심스럽게 다루는지는 비용이 되고, 제본을 살려 스캔하는 공정은 처리량 앞에서 밀려난다. 파괴는 사고가 아니라 설계에 포함된 단계다.
서적상들이 걱정하는 것은 개별 거래가 아니라 재고다. 시장에 몇 부 남지 않은 판본이 팔려 나가 스캔되면 그 판본은 유통에서 사라지고, 같은 책을 다음에 찾는 사람에게는 살 곳이 없다. 공개된 선반에 있던 텍스트가 한 회사의 닫힌 모델 안으로 옮겨 가는 셈이다. 그런데도 이 거래가 계속 성립하는 이유는 인쇄본에 값을 매길 근거가 새로 생겼기 때문이다.
2022년이라는 순도 기준선
희귀본이 표적이 된 이유를 문학적 가치로 설명하면 앞뒤가 맞지 않는다. TechCrunch가 정리한 이유는 두 가지다. 인쇄본에는 온라인에 아예 존재하지 않는 텍스트가 많고, 2022년 이전에 나온 책이라면 LLM이 쓴 문장이 섞여 있을 가능성이 없다. 뒤쪽 조건에는 이름이 붙어 있다. AI가 생성한 텍스트로 다시 학습할 때 성능이 무너지는 모델 붕괴다.
이렇게 보면 출간 연도는 편집자의 기준이 아니라 원료의 규격이다. 어떤 책이 좋은 책이냐를 묻는 조건이 아니라, 그 책의 문장이 사람의 손에서만 나왔다는 사실을 보증할 수 있느냐를 묻는 조건이다. 2023년 이후 출간물은 저자가 어떻게 썼는지에 따라 순도가 갈리는데, 그것을 밖에서 확인할 방법이 없다. 2022년이라는 선은 확인을 건너뛰고도 안전한 구간을 가를 수 있는 값싼 대용 지표다.
사람이 쓴 문장이 값이 매겨지는 자원이 되는 순간, 그 자원의 등급을 매기는 기준은 내용이 아니라 오염 여부가 된다. 합성 데이터가 데이터 가격 자체를 어떻게 흔드는지는 AI가 AI를 먹는다: 합성 데이터와 모델 붕괴에 따로 정리해 두었다.
파괴가 합법성의 근거가 된 판결
이 공정을 아마존이 처음 만든 것은 아니다. 저자들이 앤트로픽을 상대로 낸 소송 과정에서 Project Panama라는 내부 작업이 드러났다. 마켓플레이스에서 책을 사들여 제본을 자르고 디지털화하는 작업이었고, 아마존의 라스베이거스 시설에서 일어나는 일과 공정이 같다.
그 작업이 어떻게 시작됐는지는 2025년 6월 23일 명령문에 남아 있다. 앤트로픽은 2024년 2월 구글 도서 스캔 사업의 제휴 책임자였던 톰 터비를 영입하고, 법적·실무적 지연을 최대한 피하면서 세상의 모든 책을 확보하는 일을 맡겼다. 그는 2024년 봄 주요 출판사에 학습용 라이선스를 문의하는 메일을 몇 통 보냈지만 그 대화를 이어 가지 않았고, 대신 도서 유통사와 소매업체에 인쇄본을 대량으로 사겠다는 메일을 보냈다. 회사는 수백만 달러 규모를 들여 인쇄본 수백만 권을 사들였고 상당수는 중고였다. 협의로 갈 수 있던 경로를 놔둔 채 구매와 절단 쪽으로 방향을 잡았다.
같은 기록에 눈에 덜 띄는 항목이 하나 더 있다. 앤트로픽은 사들이는 책의 서지 메타데이터를 자체 목록으로 만들어 두었다. 물건은 없어지고 그 물건에 관한 기록만 남는 순서다. 나중에 어떤 스캔본이 어느 책에서 나왔는지 묻는 질문의 답은, 사라진 책이 아니라 회사가 만든 그 목록 안에 있게 된다.
그 소송에서 법원은 구매한 인쇄본을 스캔해 학습에 쓴 행위를 공정 이용으로 판단했다. 판단 근거의 하나가 여기서 중요하다. 인쇄 원본이 파괴되어 사본이 늘어나거나 다시 팔리지 않았다는 점이 유리하게 작용했다. 원본을 없애는 선택이 부작용이 아니라 방어선의 일부로 계산되어 있었던 셈이다.
같은 사건에서 해적판을 내려받아 보관한 트랙은 별개로 침해가 인정됐고, 저작물 약 48만 건에 15억 달러를 지급하는 합의로 끝났다. 두 트랙을 섞어 읽으면 판결의 메시지가 뒤집힌다. 무엇을 학습했느냐가 아니라 어떻게 손에 넣었느냐가 유무죄를 갈랐다는 점은 15억 달러가 그은 데이터 취득 경로의 경계에 정리해 두었다.
페이지를 내린 ISBNdb
수요가 어디까지 퍼져 있었는지는 7월에 한 차례 드러났다. 20년 넘게 책 메타데이터를 다뤄 온 ISBNdb의 웹사이트에 인쇄본을 소싱해 AI 기업에 판매한다는 서비스 안내가 올라와 있었다. 404 미디어가 이를 보도한 뒤 아흐레가 지난 7월 30일, 회사는 해당 페이지를 삭제하고 홈페이지와 뉴스 페이지에 설명을 붙였다.
회사가 밝힌 입장은 강한 부인이다. ISBNdb는 AI 학습을 위해서든 다른 목적을 위해서든 책을 사거나 스캔하거나 판 적이 없고, AI 모델을 학습시키지도 않았으며, 그 페이지는 시장 관심을 떠본 것이고 실제로 그런 서비스를 만든 적은 없다는 내용이었다. 자기 일은 사람들이 책을 찾도록 돕는 것이고, 20여 년간 책 세계의 카드 목록 역할을 해 왔으며, 다루는 것은 책에 관한 데이터이지 책 자체가 아니라고 덧붙였다.
거래가 없었다는 설명을 그대로 받아들여도 남는 사실이 있다. 책 메타데이터를 20년간 쌓아 온 회사가 인쇄본 중개를 시장 시험 대상으로 올려 볼 만하다고 판단했고, 그 페이지가 문제로 인식되기까지 걸린 시간은 아흐레였다. 인쇄본을 원료로 보는 시선은 한 회사의 창고 안에만 있는 것이 아니다.
원본이 사라진 뒤 남는 두 질문
여기까지가 보도된 사실이다. 이어서 물어야 할 것은 두 가지이고, 둘 다 책이 이미 잘린 다음의 문제다.
6.1계보를 나중에 무엇으로 확인하나
학습 코퍼스의 계보를 따진다는 것은 어떤 텍스트가 어떤 물건에서 나왔는지 되짚는 일이다. 이번 공정에서는 그 물건이 남지 않는다. 스캔본이 정말 그 판본에서, 그 인쇄본에서 나왔는지 확인하려면 회사가 남긴 기록을 믿는 수밖에 없다. 저작권 소송에서 원본 파괴가 방어 근거로 쓰인 구조가 여기서 한 번 더 작동한다. 파괴를 증명하면 법적 위험은 줄지만, 같은 파괴가 사후 재검증의 대상을 없앤다.
앤트로픽 기록이 보여 준 순서가 이 지점에서 문제가 된다. 사들인 책의 서지 정보는 회사 목록에 남고 책은 남지 않는다. 그러면 계보를 확인하는 작업은 처음부터 끝까지 그 목록 안에서만 이뤄지고, 목록을 만든 쪽과 검증을 받아야 하는 쪽이 같아진다. 도서관과 기록관이 디지털화 기록과 원본을 함께 남기는 이유가 이 겹침을 피하는 데 있다.
실무에서 이 차이는 감사 항목으로 나타난다. 학습 데이터의 출처를 묻는 질문에 계약서와 구매 영수증까지 답할 수 있는 조직은 늘었지만, 그 영수증이 가리키는 물건이 지금도 남아 있는지를 묻는 항목은 아직 실사 목록에 없다.
6.2대조할 원본 없이 품질을 무엇으로 보증하나
스캔은 깨끗하게 끝나지 않는다. 문자 인식이 글자를 잘못 읽고, 낱장이 겹쳐 페이지가 빠지고, 같은 제목의 다른 판본이 섞인다. 그래서 도서관과 기록관은 디지털화를 마친 뒤에도 원본을 버리지 않는다. 사본에서 이상한 대목이 나왔을 때 되돌아가 맞춰 볼 기준이 있어야 하기 때문이다.
기준점이 없으면 오류의 성격이 바뀐다. 대조 가능한 사본의 오류는 정정 대기 상태이지만, 대조할 것이 없는 사본의 오류는 그대로 사실이 된다. 그 텍스트로 학습한 모델이 잘못 읽힌 문장을 그대로 물려받아도, 어디서 틀어졌는지 확인할 자리가 남아 있지 않다. 순도를 지키려고 인쇄본을 모았는데 정확성을 검증할 방법을 함께 없애는 셈이다.
Editor's Note: 페블러스가 AI-Ready Data를 말할 때 값의 정확성만큼 함께 봐야 한다고 여기는 것이 이런 항목이다. 데이터가 어디서 왔는지, 그 출처를 지금도 다시 열어 볼 수 있는지, 다시 열 수 없다면 무엇이 그 자리를 대신하는지가 레코드에 적혀 있어야 나중에 따져 볼 수 있다. 원본을 없애는 취득 방식이 늘어날수록 취득 시점에 남기는 검증 기록의 값이 올라간다.
참고문헌
보도
- 1.Maiberg, E. (2026). "We Tracked a Shipment of Rare Books. It Ended at an Amazon AI Training Facility." 404 Media. — 위치추적장치로 아마존 VGT3 시설까지 추적한 원 폭로 보도.
- 2.Silberling, A. (2026). "Amazon, once an online bookseller, is destroying rare books to train AI models." TechCrunch. — VGT3 시설명·아마존 공식 입장·2022년 조건과 모델 붕괴 연결 서술.
- 3.Cole, S. (2026). "Company Offering Printed Books to Train AI Stops After 404 Media Coverage." 404 Media. — ISBNdb 서비스 페이지 철회 후속 보도.
법원 기록
- 4.Bartz v. Anthropic PBC, No. 3:24-cv-05417-WHA (N.D. Cal.), Doc. 231 (2025-06-23). — Project Panama 도서 매입·파괴적 스캔 사실관계 및 원본 파괴를 공정 이용 근거로 인정한 명령문.