Executive Summary
메이저리그는 2026시즌부터 볼과 스트라이크를 기계가 다시 판정할 수 있게 했다. 다만 모든 공이 아니다. 심판이 먼저 판정하고, 그 공에 관여한 투수·포수·타자 가운데 한 명이 곧바로 이의를 걸어야만 자동 판정 장치가 공의 위치를 공개하고 최종 결론을 낸다. 카이스트와 연세대 공동연구팀이 이 제도 아래에서 사람 심판의 판정이 어떻게 달라졌는지를 12시즌 치 기록으로 분석했다. 이 글은 그 결과를 사람이 1차로 판단하고 AI가 골라서 검수하는 현장의 이야기로 옮겨 읽는다.
연구팀은 판정이 볼과 스트라이크로 갈리는 자리와, 그 갈림이 얼마나 또렷한지를 따로 측정했다. 2026년에 움직인 것은 자리뿐이었다. 갈림의 또렷함은 앞선 열한 시즌의 추세를 그대로 이어 갔다. 심판이 더 잘 구분하게 된 것이 아니라 선을 긋는 위치가 기계 쪽으로 당겨졌다는 뜻이다. 한 판정이 뒤집힌 직후에는 그 경계 근처의 판정이 정정 방향으로 움직였지만, 같은 심판의 다음 경기 첫 구간에서는 그 움직임이 잡히지 않았다.
1절부터 5절까지는 논문이 보고한 내용이다. 6절의 물음은 이 글이 세운 것이다. 사람이 1차로 라벨을 붙이고 검수가 일부만 골라 되짚는 구조에서, 바뀌는 것은 그 라벨인가 라벨러인가.
주요 수치
출처: Kichang Lee, Gyeongmin Han, Sungmin Lee, JeongGil Ko, When the Strike Zone Becomes Algorithmic, arXiv:2609.25525 (2026-09-22).
53.6%
이의가 걸린 판정의 번복률
2026년 8,447건 가운데 4,525건이 뒤집혔다. 검수대에 오른 판정의 절반 이상이 원래 틀렸다는 뜻이다
5.03%
이의를 걸 수 있는 기회의 사용률
기회 146,725건 중 실제 요청은 7,381건이었다. 나머지는 검수받지 않은 채로 남는다
1경기
정정 뒤 조정이 확인된 범위
같은 경기 안에서는 통계적으로 유의했고, 다음 경기 첫 구간에서는 잡히지 않았다
+36.1%
체인지업의 안쪽 오심 증가율
전체 오심은 여섯 구종 모두 줄었지만, 이 한 칸은 반대로 늘었다. 줄어든 자리와 늘어난 자리가 갈렸다는 신호다
모든 공은 심판이 판정하고, 기계는 불러야 온다
야구를 오래 보지 않았어도 괜찮다. 제도가 어떻게 돌아가는지부터 보자. 타자가 방망이를 내지 않은 공은 포수 뒤의 심판이 스트라이크인지 볼인지 판정한다. 메이저리그는 2026시즌에 여기에 자동 볼·스트라이크 판정 장치를 들였는데, 한국 프로야구가 2024년부터 쓰는 방식과는 설계가 다르다. 한국은 모든 공을 기계가 판정한다. 메이저리그는 심판이 먼저 판정하고, 그 공에 직접 관여한 투수·포수·타자 가운데 한 명이 판정 직후 헬멧을 두드려 이의를 걸었을 때만 기계가 개입한다. 그러면 카메라 추적으로 측정한 공의 위치가 전광판에 공개되고, 원래 판정은 유지되거나 뒤집힌다.
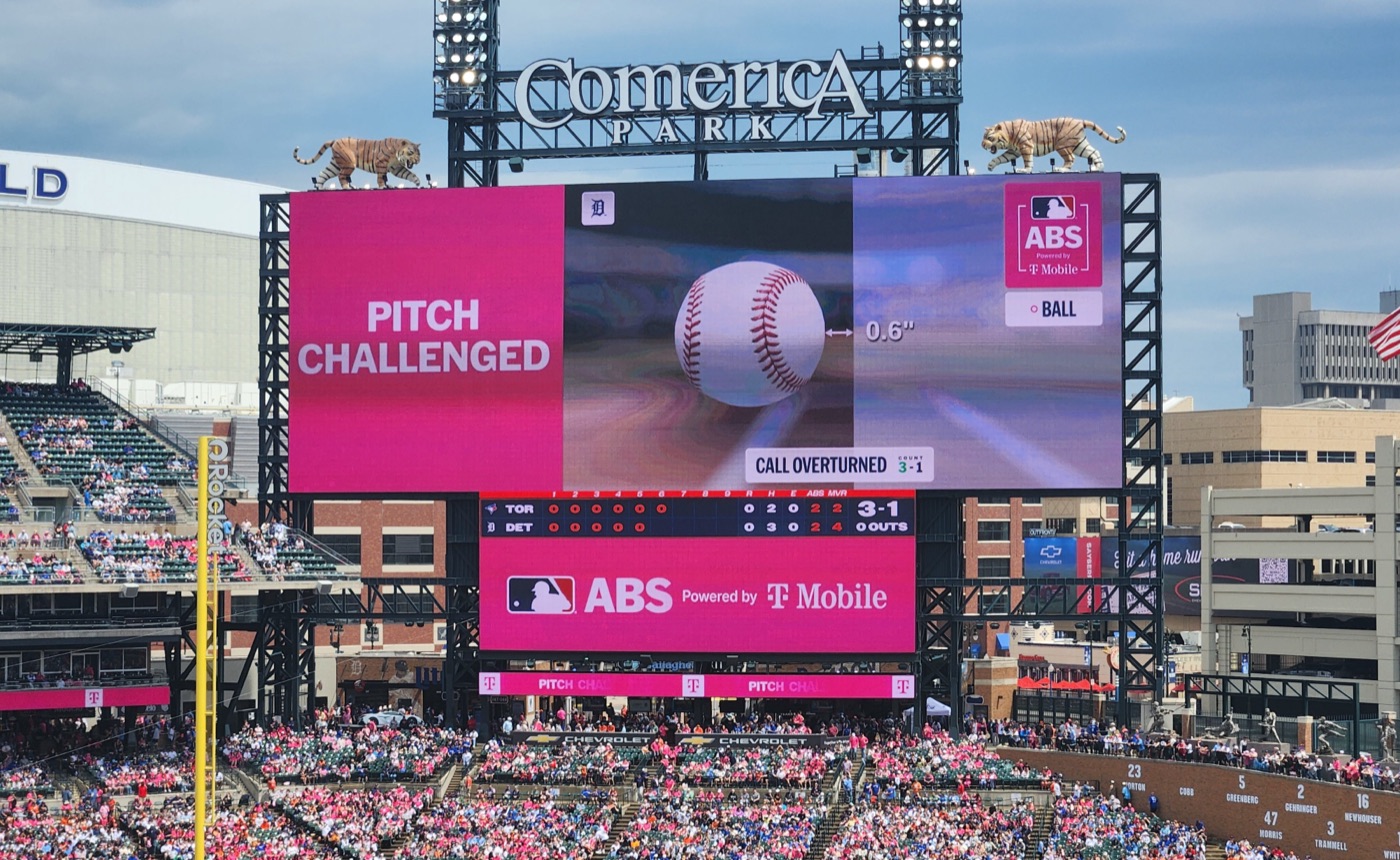
이의를 걸 기회에는 한도가 있다. 각 팀은 두 번으로 시작하고, 성공하면 그 한 번을 돌려받고 실패하면 잃는다. 남은 기회 없이 연장으로 들어간 팀에는 한 번이 주어진다. 감독은 요청할 수 없고, 판정 직후가 아니면 받아 주지 않는다. 기계가 쓰는 스트라이크존도 규정집의 그것과 다르다. 홈플레이트 중간 지점에 폭 17인치 직사각형을 세우고, 아래 경계는 타자 키의 27%, 위 경계는 53.5% 지점에 둔다.
이 설계는 우연히 나온 것이 아니다. 논문이 인용한 선행 연구는 메이저리그가 일곱 해에 걸친 실험 끝에 전면 자동 판정 대신 이의 제기 방식을 고른 과정을 추적한다. 기술적 실현 가능성과 비용, 기존 판정 관행과의 연속성, 그리고 선수가 판정에 개입할 여지를 남겨 두려는 의도가 함께 작용했다. 요청 여부를 정하는 일 자체가 경기의 일부가 되도록 만든 선택이다.
규모를 보면 이 제도가 시즌 내내 쉼 없이 돌아갔다는 것을 알 수 있다. 개막일부터 8월 24일까지 치러진 1,974경기에서 선수들은 8,447번 이의를 걸었다. 경기당 4.28번이고, 전체 경기의 98.7%에서 최소 한 번은 나왔다. 그 가운데 4,525건, 53.6%가 뒤집혔다.
여기서 이 제도의 모양이 드러난다. 심판에게는 안 친 공이 전부 판정 대상이지만, 자기 판정이 맞았는지 틀렸는지를 알려 주는 신호는 선수가 골라서 올린 공에서만 돌아온다. 판정하는 사람과 정정을 요청하는 사람이 다르고, 최종 결론을 내는 쪽은 또 다른 제3자다. 논문은 이 제도를 인간과 AI가 만나는 새로운 형태라고 부른다.
심판이 정확해진 것인지, 선을 옮긴 것인지
연구팀이 쓴 자료는 2015년부터 2026년까지 열두 시즌, 정규시즌 투구 판정 4,114,256건이다. 홈플레이트 심판 141명의 판정이 여기 들어 있고, 메이저리그가 공개하는 추적 데이터와 공개 API에서 모았다. 이만한 기간을 잡은 데는 이유가 있다. 2026년에 달라진 것은 이의 제기 제도만이 아니라 스트라이크존의 정의 자체였기 때문이다. 판정이 달라 보이는 것이 심판이 달라져서인지 잣대가 달라져서인지를 가르지 않으면 아무 말도 할 수 없다.
그래서 연구팀은 심판의 판정과 무관하게 타자 키만으로 정의되는 고정 기준존을 세우고, 열두 시즌을 전부 그 위에 올려놓았다. 시대마다 다른 존의 정의는 따로 떼어 보정했다.
자료 자체에도 손볼 것이 두 가지 있었다. 첫째, 2026년 기록에는 이의를 거친 공의 최종 판정만 남는다. 뒤집힌 공은 심판이 원래 무엇이라 불렀는지가 기록에서 지워진 셈이어서, 연구팀은 번복 표시를 거꾸로 되짚어 심판의 1차 판정을 복원했다. 둘째, 2025년까지는 공의 위치를 홈플레이트 앞면에서 측정해 기록했는데 2026년 자료는 자동 판정 장치가 쓰는 중간 지점에서 측정한 값이다. 같은 공이라도 어느 면을 기준으로 삼느냐에 따라 다른 좌표로 적히는 셈이라, 이전 열한 시즌의 공은 추적 자료의 속도와 가속도로 궤적을 이어 중간 지점 좌표를 다시 계산했다. 경계를 추정하는 데 실제로 쓰인 것은 411만 건 전부가 아니라 네 경계 가운데 한쪽에서 3인치 안에 들어온 842,456건이고, 팀마다 기회가 하나씩 더 붙는 연장 이닝은 제외했다.
그 공통 잣대 위에서 두 가지를 측정한다. 하나는 심판이 볼에서 스트라이크로 판정을 바꾸는 자리, 곧 경계의 위치다. 다른 하나는 그 전환이 얼마나 급하게 일어나는지, 곧 경계의 또렷함이다. 앞의 것은 어디에 선을 그을지에 관한 기준이고, 뒤의 것은 그 선 근처의 공을 얼마나 잘 구분하는지에 관한 능력이다.
2015년부터 2025년까지의 추세로 2026년을 예측하고 실제 관측값과 견주자, 둘의 결과가 갈렸다. 경계의 위치는 존 전체와 아래·안쪽·바깥쪽 경계에서 예측치보다 안쪽으로, 즉 자동 존 쪽으로 유의하게 내려갔다. 위 경계만 예측 범위 안에 머물렀다. 가장 크게 움직인 자리는 아래와 바깥쪽이었는데, 역사적으로 심판이 기준존 바깥까지 가장 넉넉하게 스트라이크를 주던 곳이다. 반면 경계의 또렷함은 존 전체와 네 경계 어디에서도 예측 추세를 벗어나지 않았다.
논문의 문장은 이렇다. "umpire calls changed primarily in where the boundary was placed, while the sharpness of that boundary remained consistent with its pre-adoption trajectory." 심판의 판정에서 달라진 것은 주로 경계를 어디에 두느냐였고, 그 경계의 또렷함은 제도 도입 전의 궤적을 그대로 따라갔다는 뜻이다. 기계가 지켜보게 되자 심판은 더 잘 보게 된 것이 아니라 다르게 판정하기 시작했다.
이 구분은 뒤이은 결과들을 읽는 열쇠가 된다. 볼카운트에 따라 존이 달라지는 오래된 습관은 2026년에도 그대로였다. 3볼 0스트라이크에서 가장 넓고 0볼 2스트라이크에서 가장 좁은 서열이 유지됐다. 다만 네 카운트 전부가 예측 추세보다 안쪽으로 내려갔다. 3볼 0스트라이크와 0볼 0스트라이크, 3볼 2스트라이크는 95% 예측 구간을 아예 벗어났고 0볼 2스트라이크는 그 구간의 아래 끝에 걸쳤다. 서열은 그대로인데 줄 전체가 한 칸씩 당겨진 모양이다.
논문이 여기에 덧붙인 설명은 따로 읽어 둘 만하다. 카운트마다 출발한 자리가 다르니 같은 폭으로 당겨도 결과가 같지 않다. 3볼 0스트라이크에서는 기준존 바깥으로 넉넉히 나가 있던 경계가 기준 쪽으로 다가서지만, 0볼 2스트라이크에서는 이미 기준보다 좁았던 경계가 더 안쪽으로 밀린다. 기준선을 한꺼번에 옮기는 일은 어떤 구간에서는 정정이고 어떤 구간에서는 그 반대다.
선수의 이름값에 따라 판정이 갈리던 대목에서는 조금 다른 일이 벌어졌다. 2026년 이전에는 올스타에 여러 번 뽑힌 타자일수록 더 좁은 존을 받았는데, 2026년 들어 세 지위 그룹이 서로 눈에 띄게 가까워졌다. 셋 다 예측치보다 안쪽으로 내려갔고 그 이탈은 모두 유의했다. 투수 쪽에서도 세 그룹이 비슷하게 수렴했지만 근거는 타자 쪽보다 약하다. 여기서도 또렷함은 움직이지 않았다. 지위에 따른 차이가 줄어든 것 역시 잘 보게 되어서가 아니라 선을 옮겨서 생긴 결과였다.
구종별 오심률을 보면 이 해석이 한 번 더 확인된다. 여섯 구종 모두 2026년에 오심률이 떨어졌다. 그런데 어느 쪽 오심이 줄었는지를 갈라 보면 그림이 선명해진다.
| 구종 | 전체 오심률 변화 | 바깥쪽 공을 스트라이크로 | 안쪽 공을 볼로 |
|---|---|---|---|
| 포심 패스트볼 | −26.4% | −40.3% | +0.5% |
| 싱커 | −29.0% | −41.5% | −1.3% |
| 커브볼 | −16.2% | −32.8% | +8.1% |
| 체인지업 | −28.6% | −50.5% | +36.1% |
정리: 페블러스. 논문 표 1에서 네 구종을 옮겼다. 2015~2025년 평균 대비 2026년의 상대 변화율이며, 커터와 슬라이더는 지면 관계로 생략했다. 바깥쪽 오심 감소는 여섯 구종 모두 통계적으로 유의했고(32.8~50.5% 감소), 안쪽 오심에서는 체인지업의 증가만 유의했다
전체 오심률은 커브볼 16.2%에서 싱커 29.0%까지 떨어졌지만, 그 감소분은 거의 전부 바깥쪽에서 나왔다. 존 밖으로 빠진 공이 스트라이크로 불리는 일이 여섯 구종 모두에서 크게 줄었다. 반대로 존 안으로 들어온 공이 볼로 불리는 오심은 방향이 제각각이었다. 포심과 슬라이더는 거의 그대로였고, 커브볼과 체인지업은 오히려 늘었다. 체인지업은 13.3%에서 18.1%로 올라 36.1% 증가했고 이 증가만 유의했다.
구종별로 경계의 또렷함을 보면 예측 추세를 벗어난 것은 커브볼 하나뿐이었다. 1.00에서 0.94로 내려갔다. 그런데 커브볼은 2026년에도 경계가 가장 무른 구종이었고 전체 오심 감소 폭도 가장 작았다. 전체 오심률 감소가 예측 추세에 견줘 유의했던 것은 포심과 싱커, 슬라이더, 체인지업 네 구종이고 커터와 커브볼의 감소는 유의수준에 닿지 않았다.
선을 안쪽으로 당기면 바깥쪽 오심이 줄고 안쪽 오심이 느는 것이 당연한 결과다. 구분 능력이 좋아졌다면 양쪽이 함께 줄었어야 한다. 실제로 일어난 것은 선을 당겼을 때의 결과다. 오심의 총량은 줄었지만, 줄어든 만큼이 고스란히 다른 종류의 오심으로 옮겨 간 자리가 적어도 한 칸 있었다.
그 조정은 다음 경기에서 잡히지 않는다
시즌 단위로 경계가 옮겨 갔다는 사실은, 판정 하나가 뒤집혔을 때 그 심판이 무엇을 하는지까지 알려 주지는 않는다. 분석의 눈금이 여기서 이의가 걸린 개별 사건으로 내려간다. 비교 대상은 뒤집힌 요청과 유지된 요청이다. 둘 다 심판을 공개적인 검수에 노출시키지만, 틀렸다는 정보가 돌아오는 쪽은 뒤집힌 경우뿐이다. 다만 어느 판정이 뒤집힐지가 무작위로 정해진 것은 아니므로, 연구팀도 이 비교를 인과가 아니라 두 상황 사이의 차이로 읽는다고 밝혀 두었다.
기대는 방향이 정해져 있다. 볼이 스트라이크로 뒤집혔다면 그 심판의 존이 너무 좁았다는 뜻이니 경계는 바깥으로 움직여야 한다. 스트라이크가 볼로 뒤집혔다면 너무 넓었다는 뜻이니 반대다. 같은 경기의 남은 구간을 보면 실제로 그 방향으로 움직였다. 너무 좁았다는 판정이 나온 뒤 해당 경계가 바깥으로 벌어지는 변화는 통계적으로 유의했다(p=0.014). 너무 넓었다는 판정 뒤의 수축은 방향은 맞았지만 유의수준에 닿지 못했다(p=0.145).
중요한 것은 이 움직임이 어디에 머물렀는지다. 조정은 정정을 받은 그 경계에서만 나타났고, 같은 경기의 나머지 세 경계로는 번지지 않았다. 판정의 또렷함에도 일관된 변화가 없었다. 심판이 존 전체를 다시 그린 것이 아니라 지적받은 한 변만 손댔다는 뜻이다.
이 결과가 말해 주는 것은 방향과 자리까지다. 정정을 받은 경계의 추정치도 대부분 신뢰구간이 0을 포함하고 있어서, 어느 경계가 몇 인치 움직였다고는 말할 수 없다. 경기와 경계로 쪼갠 칸 하나에 들어가는 판정이 평균 여덟 개가 안 되기 때문이다. 같은 경기 분석에 쓰인 것은 7,040칸에 걸친 59,076건이고 다음 경기 분석은 25,938건이다.
그다음 질문이 이 연구에서 가장 값이 나가는 대목이다. 정정을 받은 심판의 변화는 하루를 넘겨서도 남는가. 연구팀은 같은 심판이 다음 경기를 시작하는 구간, 아직 새로운 정정을 받기 전의 판정들을 따로 떼어 같은 방식으로 측정했다. 두 방향 모두 추정치가 0 근처에 붙었다. 너무 좁았다는 정정 뒤에는 p=0.996, 너무 넓었다는 정정 뒤에는 p=0.670이었다. 경기가 하나 끝나면 흔적이 남지 않는다.
논문이 이 절의 요점으로 적어 둔 문장은 이렇다. "Individual overturns are followed by localized directional adjustments within the same game, but these responses are not detectably preserved into the next game." 개별 번복 뒤에는 같은 경기 안에서 국지적이고 방향이 맞는 조정이 뒤따르지만, 그 반응은 다음 경기까지 감지될 만큼 보존되지 않는다.
저자들은 여기에 단서를 달아 둔다. 다음 경기 구간의 신뢰구간이 넓어서, 더 작은 크기의 이월 효과까지 없다고 잘라 말할 수는 없다. 눈에 잡히는 크기의 변화는 정정을 받은 그 경기 안에 있었고, 그 경기를 넘어가서는 잡히지 않았다. 논문이 맨 끝에 적어 둔 범위 제한도 같은 쪽을 가리킨다. 여기 실린 모든 수치는 심판 141명 집단에 대한 추정치이고, 관측 기간은 새 제도가 들어온 첫 시즌의 일부다. 특정 심판의 역량을 평가하는 근거로는 쓸 수 없다고 저자들은 못 박아 두었다.
시즌 단위로 경계가 이동한 것과 이 결과를 나란히 놓으면 흥미로운 그림이 나온다. 개별 정정의 효과는 하루짜리였는데, 한 시즌을 놓고 보면 심판 집단 전체의 기준선은 확실히 옮겨 갔다. 연구팀은 이 두 층을 서로 다른 경로로 본다. 하루짜리 조정은 정정을 받은 뒤의 즉각적인 반응이고, 시즌 단위의 이동은 언제든 검수받을 수 있다는 조건 자체가 만들어 낸 변화다. 뒤의 변화는 특정 판정 하나와 이어 붙일 수 없어서, 제도 도입 전 추세와의 이탈로만 확인된다.
선수는 기계의 좌표가 아니라 눈에 보이는 단서로 고른다
이 제도에서 검수가 언제 일어날지를 정하는 쪽은 심판도 기계도 아닌 선수다. 세 번째 질문은 그 선택을 향한다. 분석 대상은 이의를 걸 수 있었던 기회 146,725건과 실제로 걸린 7,381건이다. 사용률은 5.03%다.
먼저 물어볼 것은 단순하다. 기계 기준으로 명백히 틀린 판정일수록 이의가 더 자주 걸리는가. 그렇기는 했다. 다만 올라가는 폭이 기대에 한참 못 미쳤다. 자동 존 경계에서 1인치에서 3인치까지 벗어나 기계가 봤다면 거의 확실히 뒤집었을 구간에서도, 타격 측의 요청 비율은 대략 0.19에서 0.30, 수비 측은 0.31에서 0.65에 머물렀다. 요청할 기회가 남아 있는데도 뒤집힐 판정을 그냥 넘긴 경우가 상당수라는 뜻이다. 수비 측이 타격 측보다 전 구간에서 더 자주 요청했는데, 이 차이가 볼 수 있는 정보의 차이에서 온 것인지 판단할 시간의 차이에서 온 것인지는 이 분석으로 가릴 수 없다고 저자들은 적었다.
여기서 연구팀은 한 걸음 더 들어간다. 뒤집힐지 말지를 실제로 정하는 것은 공의 정확한 위치인데, 선수는 그 위치를 볼 수 없다. 그래서 뒤집힐 확률을 두 가지로 예측해 봤다. 하나는 자동 존 대비 공의 정확한 위치를 아는 상태에서 낸 확률이고, 다른 하나는 판단하는 순간 선수가 실제로 알 수 있는 정보만으로 낸 확률이다. 같은 관측으로 모형을 맞추고 그 관측을 다시 설명하는 일이 없도록, 두 확률 모두 앞선 달의 자료로만 학습해 다음 달에 적용하는 방식으로 만들었다.
결과는 한쪽으로 기울었다. 정확한 좌표 기준으로는 확률이 크게 달라져도 요청 비율이 거의 움직이지 않았다. 중간 구간 전체에서 벌어진 폭이 0.06 남짓이다. 반면 선수가 볼 수 있는 정보 기준으로는 확률이 오를수록 요청 비율이 뚜렷하게 따라 올랐고, 그 폭은 0.21에 이르렀다. 남은 기회가 하나냐 둘이냐는 영향이 크지 않았다. 확률이 아주 높은 구간에서만 두 기회를 쥔 팀이 조금 더 자주 요청했을 뿐이다.
논문이 적어 둔 요점은 이렇다. "Players' challenge decisions align more closely with information available at decision time than with exact ABS geometry. Many overturnable calls remain unchallenged …" 선수의 요청 결정은 자동 판정 장치가 쓰는 정확한 기하학보다 판단 시점에 얻을 수 있는 정보와 더 가깝게 맞물린다. 뒤집힐 수 있었던 판정 다수는 요청 없이 남는다.
이 대목에도 단서가 붙는다. 볼 수 있는 정보가 높다고 나온 구간에서도 요청 비율은 1에 한참 못 미쳤다. 관측 가능한 정보만으로 요청되지 않은 오심을 전부 설명할 수는 없다는 뜻이다.
얼마나 알려 줄지가 선수와 심판을 함께 바꾼다
논의 절에서 저자들은 한국 프로야구를 대조군으로 끌어온다. 매 투구를 자동으로 판정하는 리그에서는 기계의 결론이 계속 흘러나오므로, 팀이 그 출력을 자동 존에 관한 정보원으로 삼을 수 있다. 논문은 실제 경기에서 관찰한 두 가지 전달 방식을 다시 그려 실었다. 존을 아홉 칸으로 나눠 번호를 매긴 판과, 공의 위치를 짧게 알리는 손동작이다. 리그의 표준 관행이라는 뜻은 아니고, 시스템의 출력이 열려 있으면 참가자들이 스스로 소통 층을 만든다는 사례로 든 것이다.
메이저리그의 이의 제기 방식은 이와 정반대 자리에 있다. 결론이 공개되는 공은 누군가 이의를 건 공뿐이다. 돌아오는 정보가 희박할 뿐 아니라, 이미 누군가 틀렸다고 의심한 공만 뽑혀 나온다는 점에서 표본 자체가 치우쳐 있다. 4절에서 본 선수들의 선택도 이렇게 희박하고 치우친 정보에서 나온다. 정확한 좌표보다 그 순간 짐작할 수 있는 것에 기대어 요청 여부를 정한 것이다. 자동 존이 실제로 어디 그어져 있는지, 그날 심판이 그 선에서 얼마나 벗어나 있는지를 알아 갈 재료가 부족한 것이다.
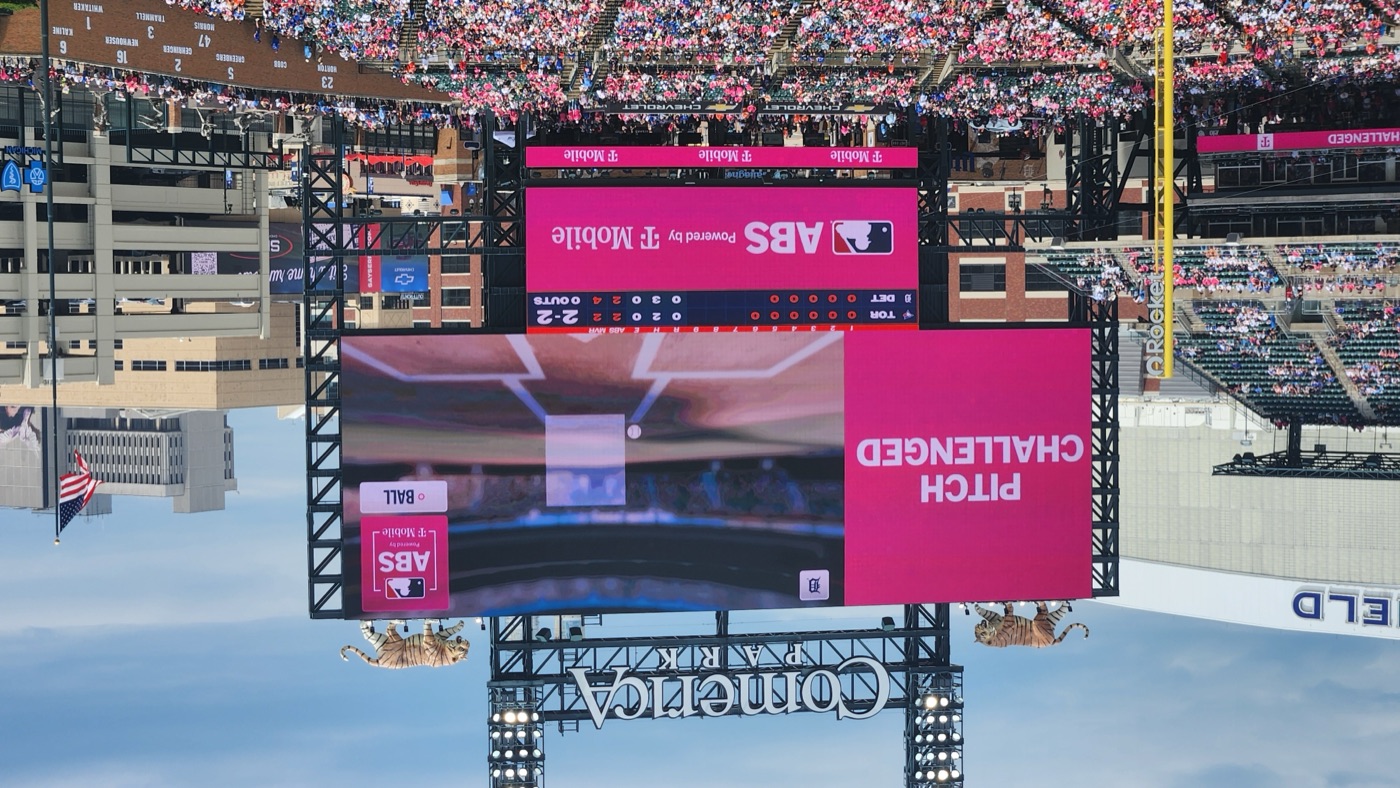
그래서 저자들이 던지는 설계 질문은 정확도에 관한 것이 아니다. 알고리즘의 판단을 참가자에게 얼마나, 어떤 형태로, 경기의 어느 시점에 돌려줄 것인가. 그 선택이 검수받는 사람과 검수를 부르는 사람 양쪽의 행동을 바꾼다.
논문은 이 질문을 관중에게까지 넓힌다. 연구팀은 매 구를 자동 판정하는 리그의 시청자 32명에게 물었다. 연구진 지인을 편의로 모집한 소규모 조사이고 기관 심의는 면제 판정을 받았으니, 수치가 아니라 관점을 얻는 용도로 읽어야 한다. 이들이 이의 제기 방식의 장점으로 꼽은 것은 둘이었다. 포수가 경계에 걸친 공을 받아 내는 기술이 여전히 값을 유지한다는 점, 그리고 선수가 이의를 걸지 말지 판단하는 새로운 능력을 지켜보는 재미다. 규칙이 바뀌면서 선수의 능력을 보는 각도가 하나 늘었고, 관중이 그 각도를 즐길 거리로 받아들였다는 이야기다.
페블러스가 이 연구를 주목하는 이유
여기서부터는 이 글의 읽기다. 우리는 야구를 다루지 않고 데이터를 다룬다. 그런데 이 논문이 분석한 구조는 데이터 라벨링과 품질 검수 현장의 기본 설계와 같은 모양이다. 사람이 1차로 라벨을 붙이고, 전부가 아니라 일부만 검수 대상으로 올라가고, 올라간 건에 대해서는 검수 쪽 판단이 최종이 된다. 저자들도 마지막 논의에서 이 구조가 야구 밖의 인간·AI 시스템에 그대로 적용된다고 적어 두었다. 사람의 권한을 남겨 둔 채 알고리즘이 선택적으로 감독하는 모든 현장이다.
이 연구가 우리 쪽 통념에 부딪히는 지점이 세 군데 있다.
6.1검수가 고치는 것은 그 건인가, 그 사람인가
검수자를 붙이면 라벨이 정확해진다고들 말한다. 이 연구가 보여 준 것은 그보다 넓다. 검수 대상이 된 판정 하나가 바로잡히는 것과 별개로, 판정하는 사람의 기준선 자체가 움직였다. 검수를 붙인 효과는 검수한 건에만 남지 않는다. 품질 지표를 검수한 건에서만 측정하고 있다면, 실제로 일어난 변화의 대부분을 못 보고 있는 셈이다.
방향도 함께 봐야 한다. 심판은 더 잘 구분하게 된 것이 아니라 다른 자리에 선을 그었다. 라벨링으로 옮기면, 검수를 붙였더니 애매한 사례를 더 잘 가르게 된 것과 검수자의 취향에 맞춰 기준을 옮긴 것은 전혀 다른 일이다. 앞의 것은 역량이고 뒤의 것은 순응이다. 정확도 하나만 보고 있으면 둘이 같은 숫자로 보인다.
6.2오류의 총량이 줄어도 종류는 바뀐다
체인지업의 안쪽 오심이 36.1% 늘어난 대목이 이 글에서 가장 실무적인 숫자다. 여섯 구종 전부에서 전체 오심률은 떨어졌는데, 그 감소는 거의 전부 한쪽 종류의 오류에서 나왔고 반대쪽에서는 늘어난 칸이 생겼다. 기준선을 옮기면 필연적으로 일어나는 일이다.
이 교환을 이 논문이 처음 찾아낸 것은 아니다. 테니스에 호크아이 판독이 들어온 뒤를 분석한 앞선 연구도 같은 일을 보고했다. 심판들이 경계 근처 오심을 전체적으로 줄이면서도, 공이 라인 안에 들어왔다고 부르는 쪽으로 판정을 기울였다는 것이다. 총 정확도가 올라가는 일과 오류의 종류가 갈아치워지는 일은 함께 일어날 수 있다. 종목이 다른 두 곳에서 같은 모양이 나왔다면, 이것은 야구의 특이한 사정이 아니라 선택적 검수가 붙은 판단 구조의 성질에 가깝다.
데이터셋 품질을 총 정확도 하나로 보고하는 관행은 그래서 위험하다. 검수를 강화한 뒤 전체 오류율이 떨어졌다는 보고는, 어떤 구간에서는 오류가 늘었다는 사실과 아무 모순 없이 공존한다. 그 구간이 마침 모델이 취약한 구간이라면 품질 수치는 좋아지고 모델 성능은 나빠진다. 오류를 종류별로 갈라 보지 않으면 이 교환이 일어났다는 것조차 알 수 없다.
6.3무엇이 검수대에 오르는지가 품질을 정한다
이의를 걸 수 있는 기회 가운데 실제로 요청된 것은 5.03%였다. 그 5.03%를 고르는 기준은 정답과의 거리가 아니라 선수가 그 순간 알 수 있는 것이었다. 라벨링 파이프라인의 말로 옮기면 에스컬레이션 규칙이다. 신뢰도 점수가 낮은 건, 작업자가 플래그를 단 건, 특정 클래스에 속한 건이 검수 큐로 넘어간다. 전부 관측 가능한 대리 지표이고, 정답과의 거리가 아니다.
이 구조에서는 검수자의 실력보다 선별 규칙이 최종 품질을 더 크게 좌우할 수 있다. 검수 정확도를 아무리 끌어올려도 애초에 올라오지 않는 오류에는 닿지 않기 때문이다. 이 논문에서 그 사각지대의 크기는 뚜렷했다. 기계가 봤으면 거의 확실히 뒤집었을 판정에서조차 요청 비율이 0.19에서 0.65 사이에 그쳤다.
선택적 검수 구조를 설계하거나 운영하고 있다면, 이 논문에서 옮겨 올 만한 물음을 네 가지로 적어 둔다. 논문이 제시한 점검표가 아니라 이 글이 우리 업무로 가져온 것이다.
- 검수를 붙인 뒤 품질 변화를 검수한 건에서만 측정하고 있는가. 검수받지 않은 건의 라벨 분포가 함께 움직였는지 확인한 적이 있는가.
- 작업자가 애매한 사례를 더 잘 가르게 된 것인지, 아니면 기준 자체가 검수자 쪽으로 밀려간 것인지 구분할 수 있는가. 총 정확도 한 줄로는 둘이 같아 보인다.
- 오류를 종류별로 나눠 보고 있는가. 한쪽 오류가 줄면서 다른 쪽이 늘어난 구간이 있는지, 그 구간이 모델에 중요한 곳인지 알고 있는가.
- 무엇을 검수대에 올릴지 정하는 규칙이 정답과의 거리를 얼마나 반영하는가. 반영하지 못한다면 그 규칙이 놓치는 오류의 크기를 측정해 둔 적이 있는가.
네 번째 물음이 가장 무겁다. 그 선별 규칙은 어떤 오류가 고쳐질지와, 한 사람에게 정정이 얼마나 자주 돌아올지를 함께 정한다. 하루가 지나면 흔적이 사라졌다는 결과는, 정정을 받은 사람의 변화가 저절로 쌓이지는 않는다는 뜻이기도 하다. 사람이 달라지길 바란다면 정정 한 번으로는 부족하고, 그 정정이 얼마나 자주 어떤 형태로 돌아오는지를 설계해야 한다. 페블러스가 데이터 품질을 볼 때 라벨의 정확도만이 아니라 그 라벨이 만들어진 조건과 검수 이력을 함께 남겨 두라고 말하는 이유가 여기 있다. 기록이 없으면 무엇이 옮겨 갔는지 나중에 짚을 수 없다.
이 논문이 그 사례다. 2절에서 짚은 대로, 2026년 공개 기록에 남는 것은 이의 절차를 통과한 뒤의 결과다. 연구팀이 분석에 착수할 수 있었던 것은 어느 공이 뒤집혔는지를 표시하는 열이 함께 남아 있었기 때문이다. 그 표시가 없었다면 심판의 기준선이 옮겨 갔는지 물어볼 방법조차 없었다. 검수를 거친 데이터셋이 검수 후 라벨만 남긴다면 우리가 잃는 것은 틀린 라벨 하나가 아니다. 라벨러가 어떻게 달라졌는지 물을 수 있는 자격이다.
여기까지 읽어 주셔서 감사하다. 이 글이 인용한 수치와 문장은 arXiv에 공개된 논문 원문에서 확인할 수 있다. 여러분의 파이프라인에서 검수 대상을 고르는 규칙은 무엇인가. 그 규칙이 놓친 오류를 마지막으로 세어 본 것이 언제인지 이야기를 나눠 주시면 좋겠다.
참고문헌
- 1.Lee, K., Han, G., Lee, S., Ko, J. (2026). "When the Strike Zone Becomes Algorithmic: Umpire Judgment and Player Challenge Decisions under AI Review." arXiv:2609.25525.
- 2.Almog, D., Gauriot, R., Page, L., Martin, D. (2024). "AI oversight and human mistakes: evidence from centre court." Proceedings of the 25th ACM Conference on Economics and Computation (EC '24), 103–105.
- 3.Wang, A. W., Kamino, W., Mimno, D., Levy, K., Jung, M. F. (2026). "Inside Baseball: The Automated Ball-Strike System as an Object Lesson in Technological Rule Enforcement." The 2026 ACM Conference on Fairness, Accountability, and Transparency (FAccT '26), 5828–5845.